
Stock Crawler AI
free & opensource repository https://github.com/chrisreiter/CRSOFT.StockCrawler.AI
CRSOFT.StockCrawler: Wenn Zahlen, Nachrichten und Fachwissen gemeinsam den Markt lesen
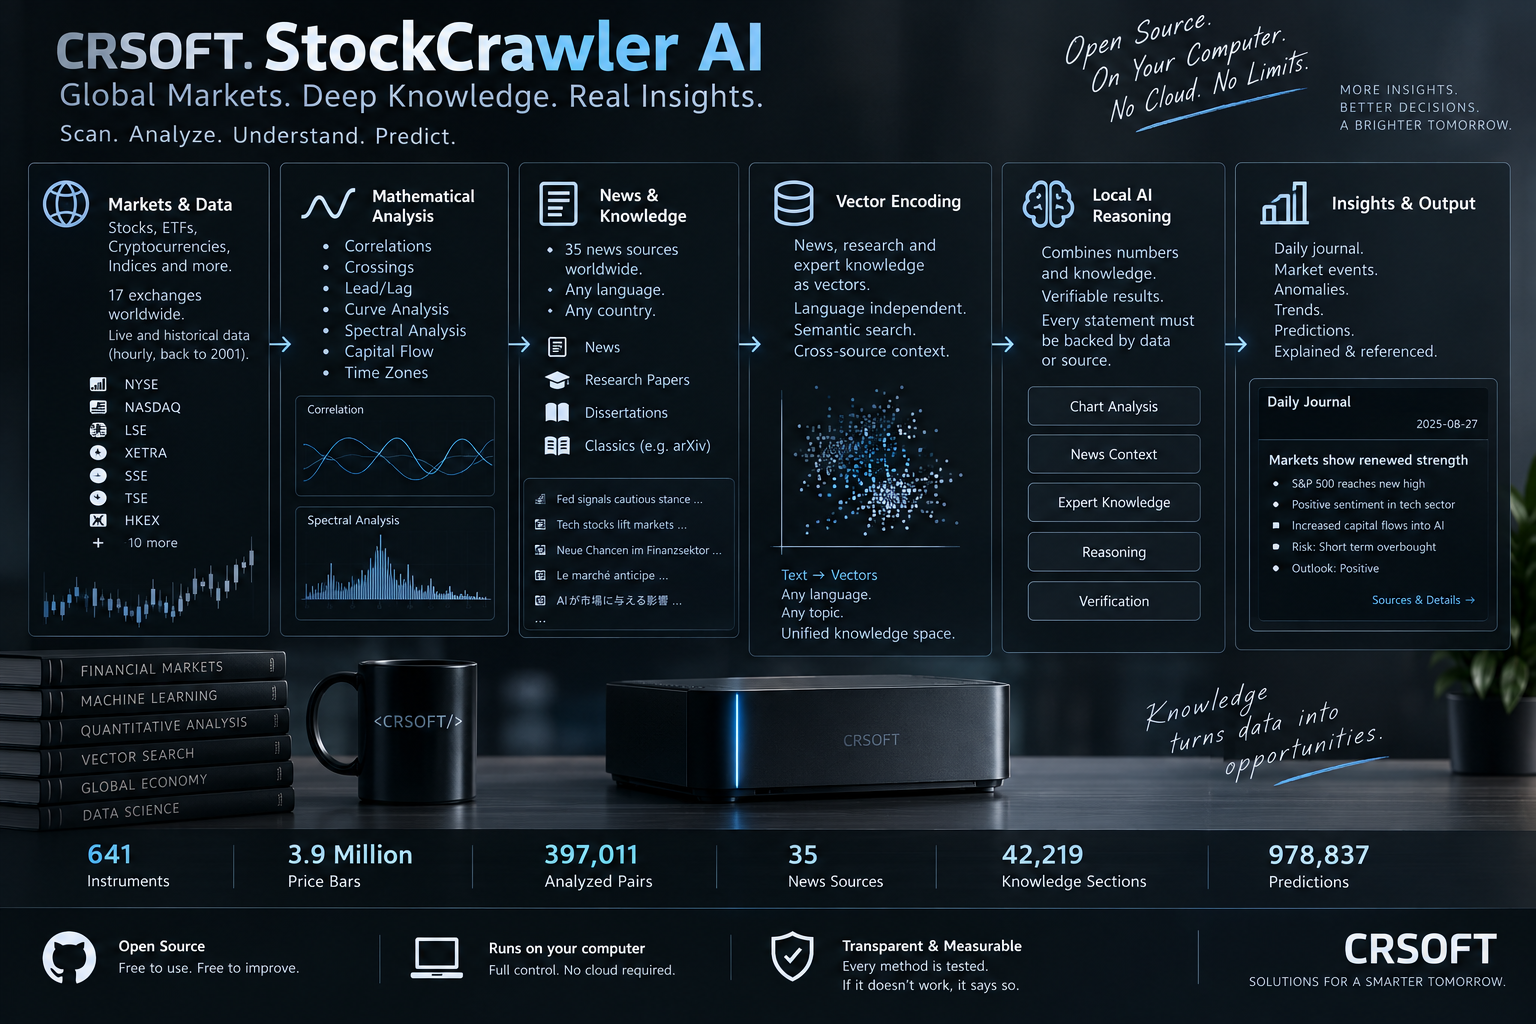
Was wäre, wenn ein einziges System Aktien, ETFs, Kryptowährungen und Indizes von 17 Börsenplätzen mathematisch analysiert – und gleichzeitig Börsennachrichten aus aller Welt sowie die Fachliteratur dazu versteht?
Sprachunabhängig. Auf einem Rechner. Ohne Cloud. Offen und kostenlos.
Genau das ist CRSOFT.StockCrawler.
Das System verbindet Kursdaten, mathematische Analysen, Nachrichten und Fachliteratur in einem gemeinsamen Vektorraum. NVIDIA Nemotron führt diese Informationen zusammen – und muss jede verwendete Zahl belegen.
In Zahlen bedeutet das:
641 Werte · 3,9 Millionen Kursbars · 397.011 ausgewertete Wertpaare · 35 Nachrichtenquellen · 42.219 Abschnitte Fachliteratur · 978.837 Prognosen.
Das ist der Aufbau, für den Anbieter fünfstellige Jahreslizenzen verlangen.
Doch dann kommt der Teil, den viele davon nicht mitliefern: die Messung, was davon tatsächlich trägt. Alles wird gegen einen Sperrbereich geprüft. Und wenn ein Verfahren nichts leistet, steht das offen in der Oberfläche – nicht im Kleingedruckten.
Die ganze Kette in einem System
   Kurse          17 Börsen, live, stündlich, zurück bis 2001
      ↓
   Mathematik     Korrelationen · Kreuzungen · Vorlauf · Kurvendiskussion
      ↓           Spektralanalyse · Kapitalfluss · Zeitzonen
   Nachrichten    35 Quellen weltweit, in jeder Sprache
      ↓
   Vektorraum     sprachunabhängig – gemeinsam mit der Fachliteratur:
      ↓           arXiv, Dissertationen, Klassiker
   Reasoning      NVIDIA Nemotron, das jede Zahl belegen muss
      ↓
   Täglich        Journal · Auffälligkeiten · Trends · Prognosen
641 Werte von 17 Börsenplätzen
Der Ausgangspunkt sind 405 Aktien, 109 Kryptowährungen, 107 Fonds und ETFs sowie 20 Indizes und Devisen.
Die Daten kommen unter anderem von Xetra sowie aus Paris, London, Zürich, Tokio, Amsterdam, Wien, Mailand, Madrid, Stockholm, Hongkong und von den US-Börsen. Insgesamt umfasst der Bestand 3.941.331 Kursbars in Tages- und Stundenauflösung – teilweise bis ins Jahr 2001 zurück. Stündlich kommen neue hinzu.
Dass verschiedene Börsen unterschiedliche Handelskalender haben, klingt zunächst wie ein Detail. Tatsächlich ist es eine der häufigsten Fallen: Wer über das rohe Zeitraster rechnet, misst schnell den Kalender statt den Markt – und zwar überzeugend genug, um es zu glauben.
Drei Auswertungen dieses Projekts sind genau daran gescheitert, bevor das Problem behoben war.
Mathematik statt Bauchgefühl
Auf dieser Datengrundlage beginnt die mathematische Auswertung:
- 397.011 Wertpaare wurden auf Korrelation, besten Lag und Richtung ausgewertet.
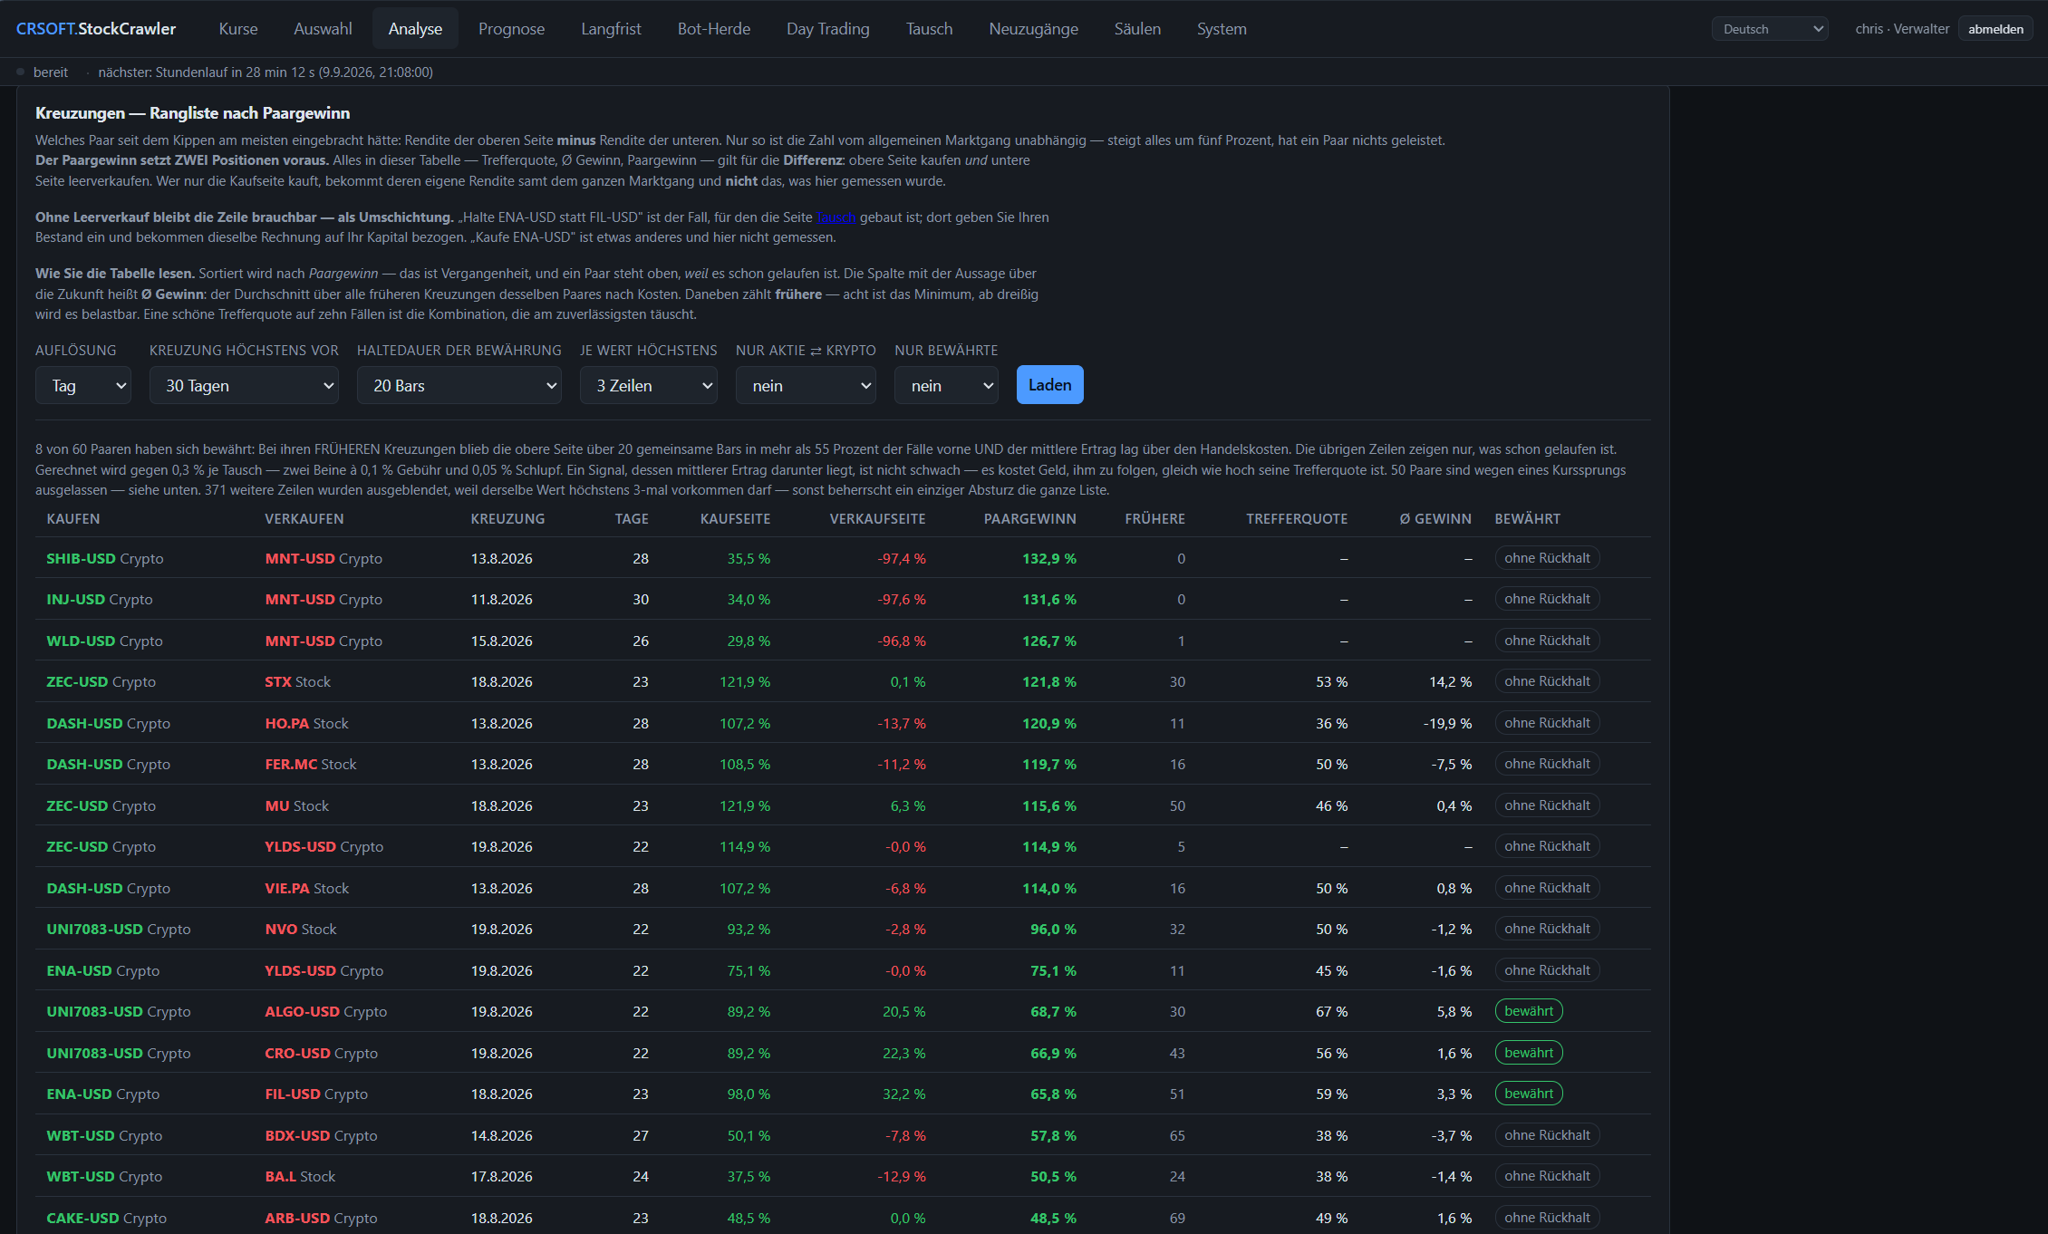
- Kreuzungen zeigen, wann zwei normalisierte Kurven die Plätze getauscht haben – mit Rangliste nach Paargewinn und Bewährung in getrennten Zeiträumen.
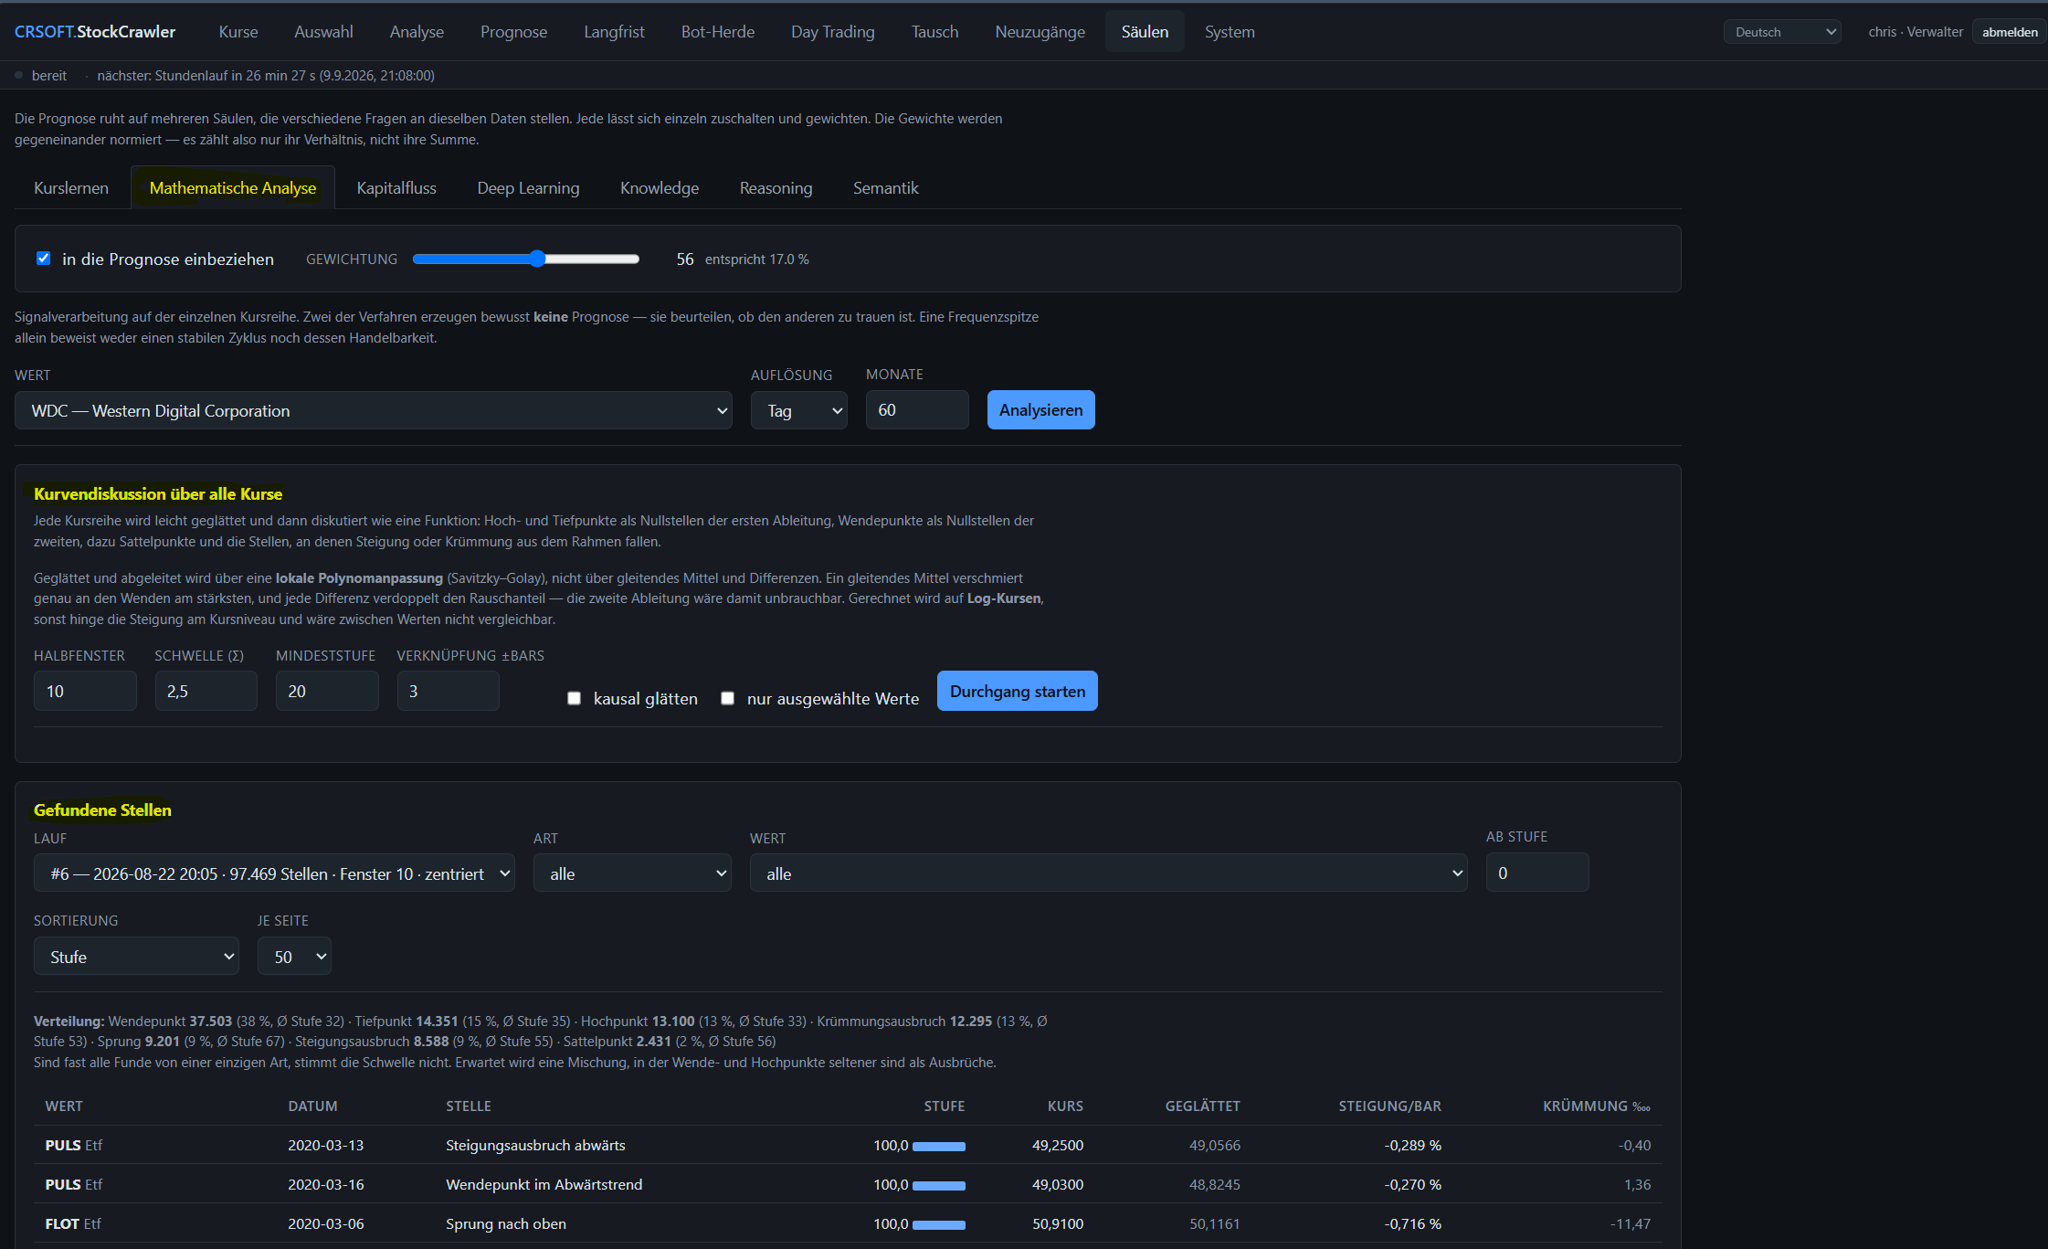
- Die Kurvendiskussion sucht über den gesamten Bestand nach Hoch-, Tief-, Wende- und Sattelpunkten. Grundlage sind lokale Polynomanpassungen sowie Steigungs- und Krümmungsausbrüche.
- Frühindikatoren und Zeitzonen-Vorlauf vergleichen Tokio, Europa und New York – mit sauberer Trennung von echtem Vorlauf und bloßer Überlappung.
- Die Spektralanalyse untersucht Periodenlängen, Zyklenstabilität, Momentanzyklen und SSA.
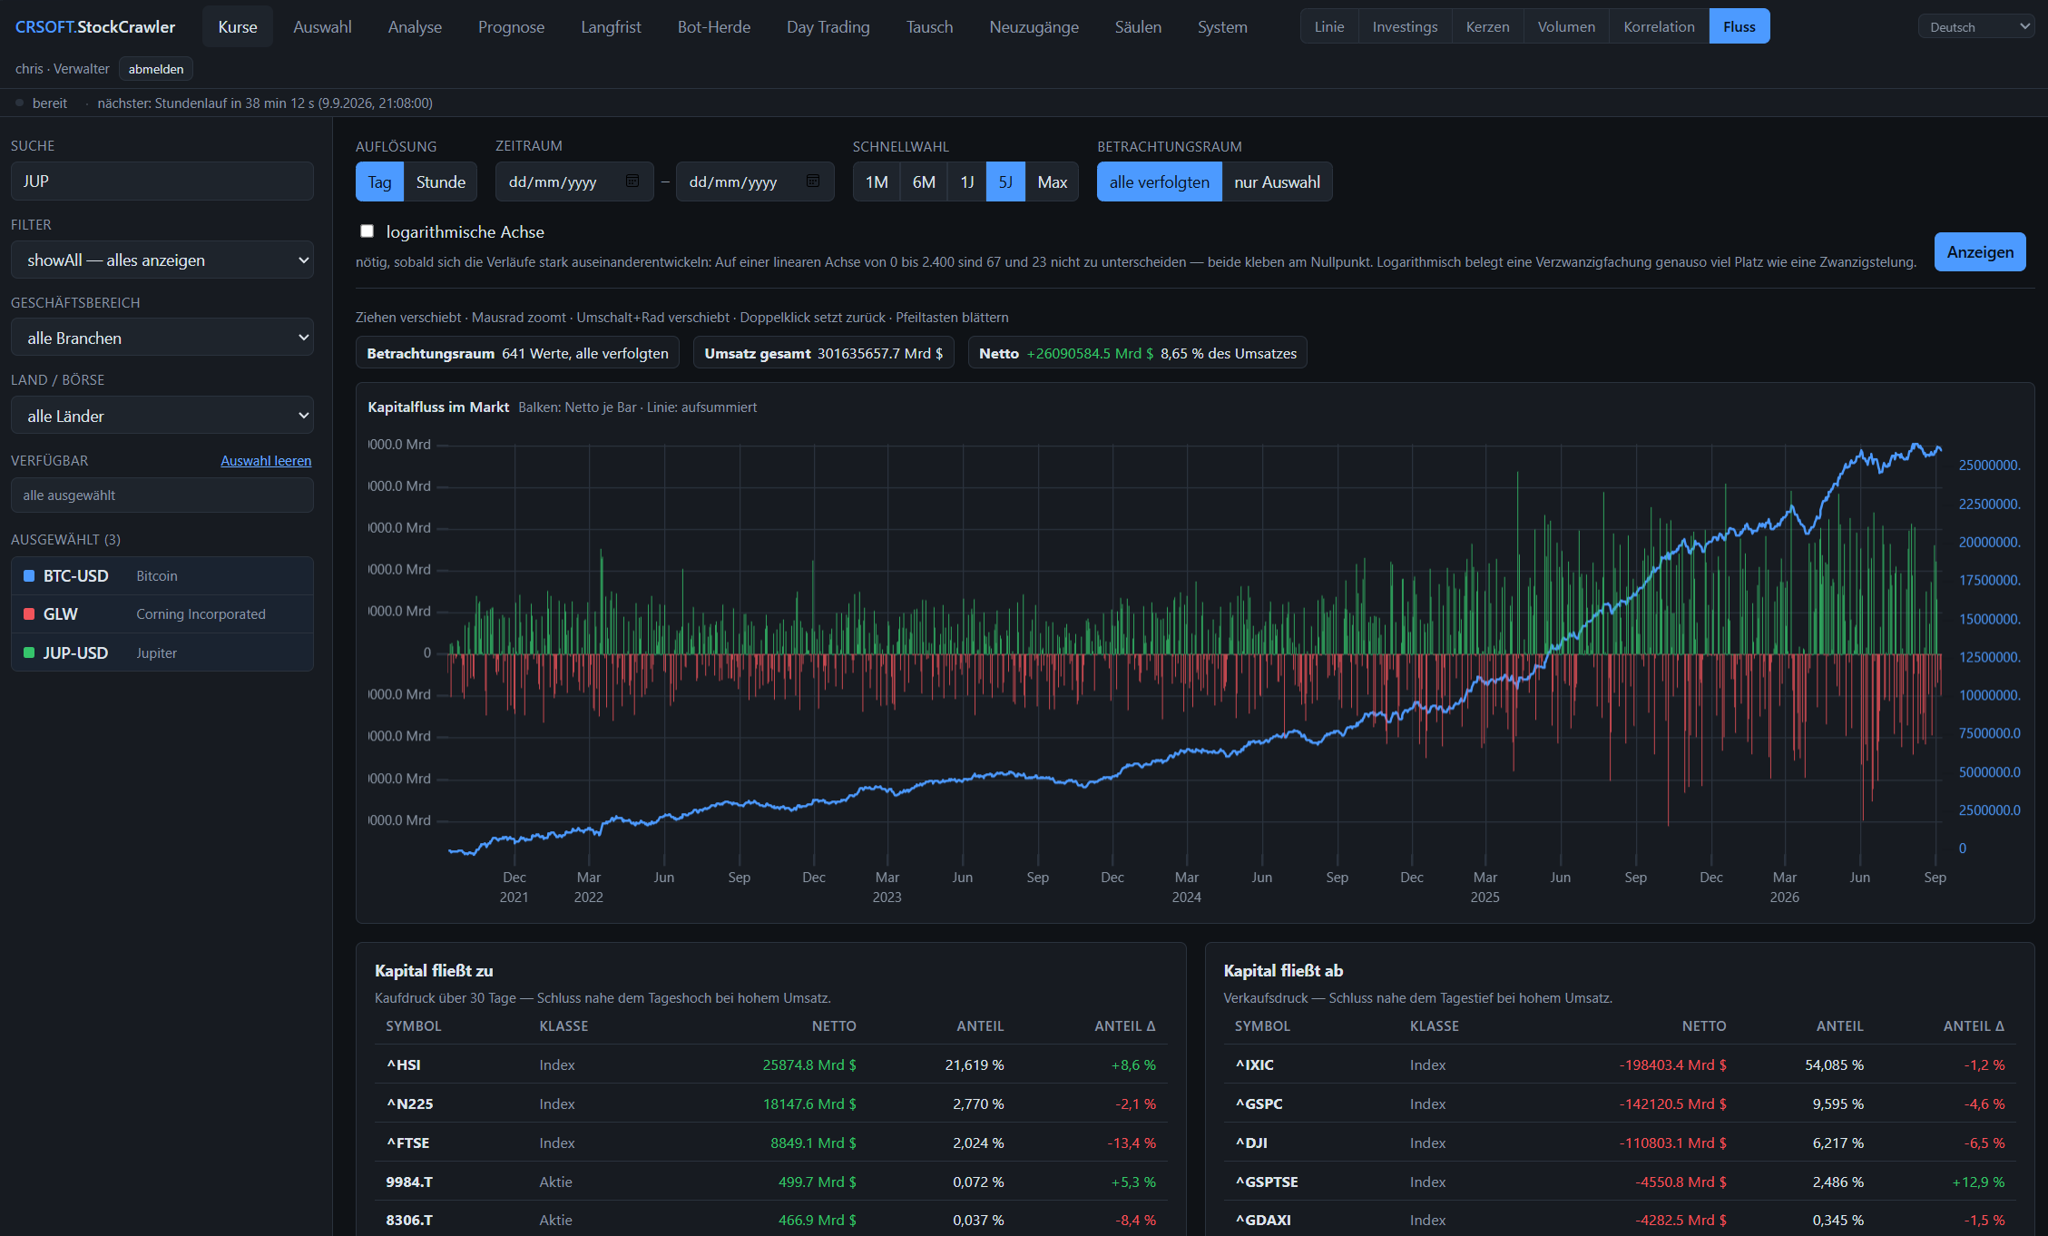
- Der Kapitalfluss unterscheidet Umverteilung von Zu- und Abfluss und erkennt möglichen Rotationsverdacht.
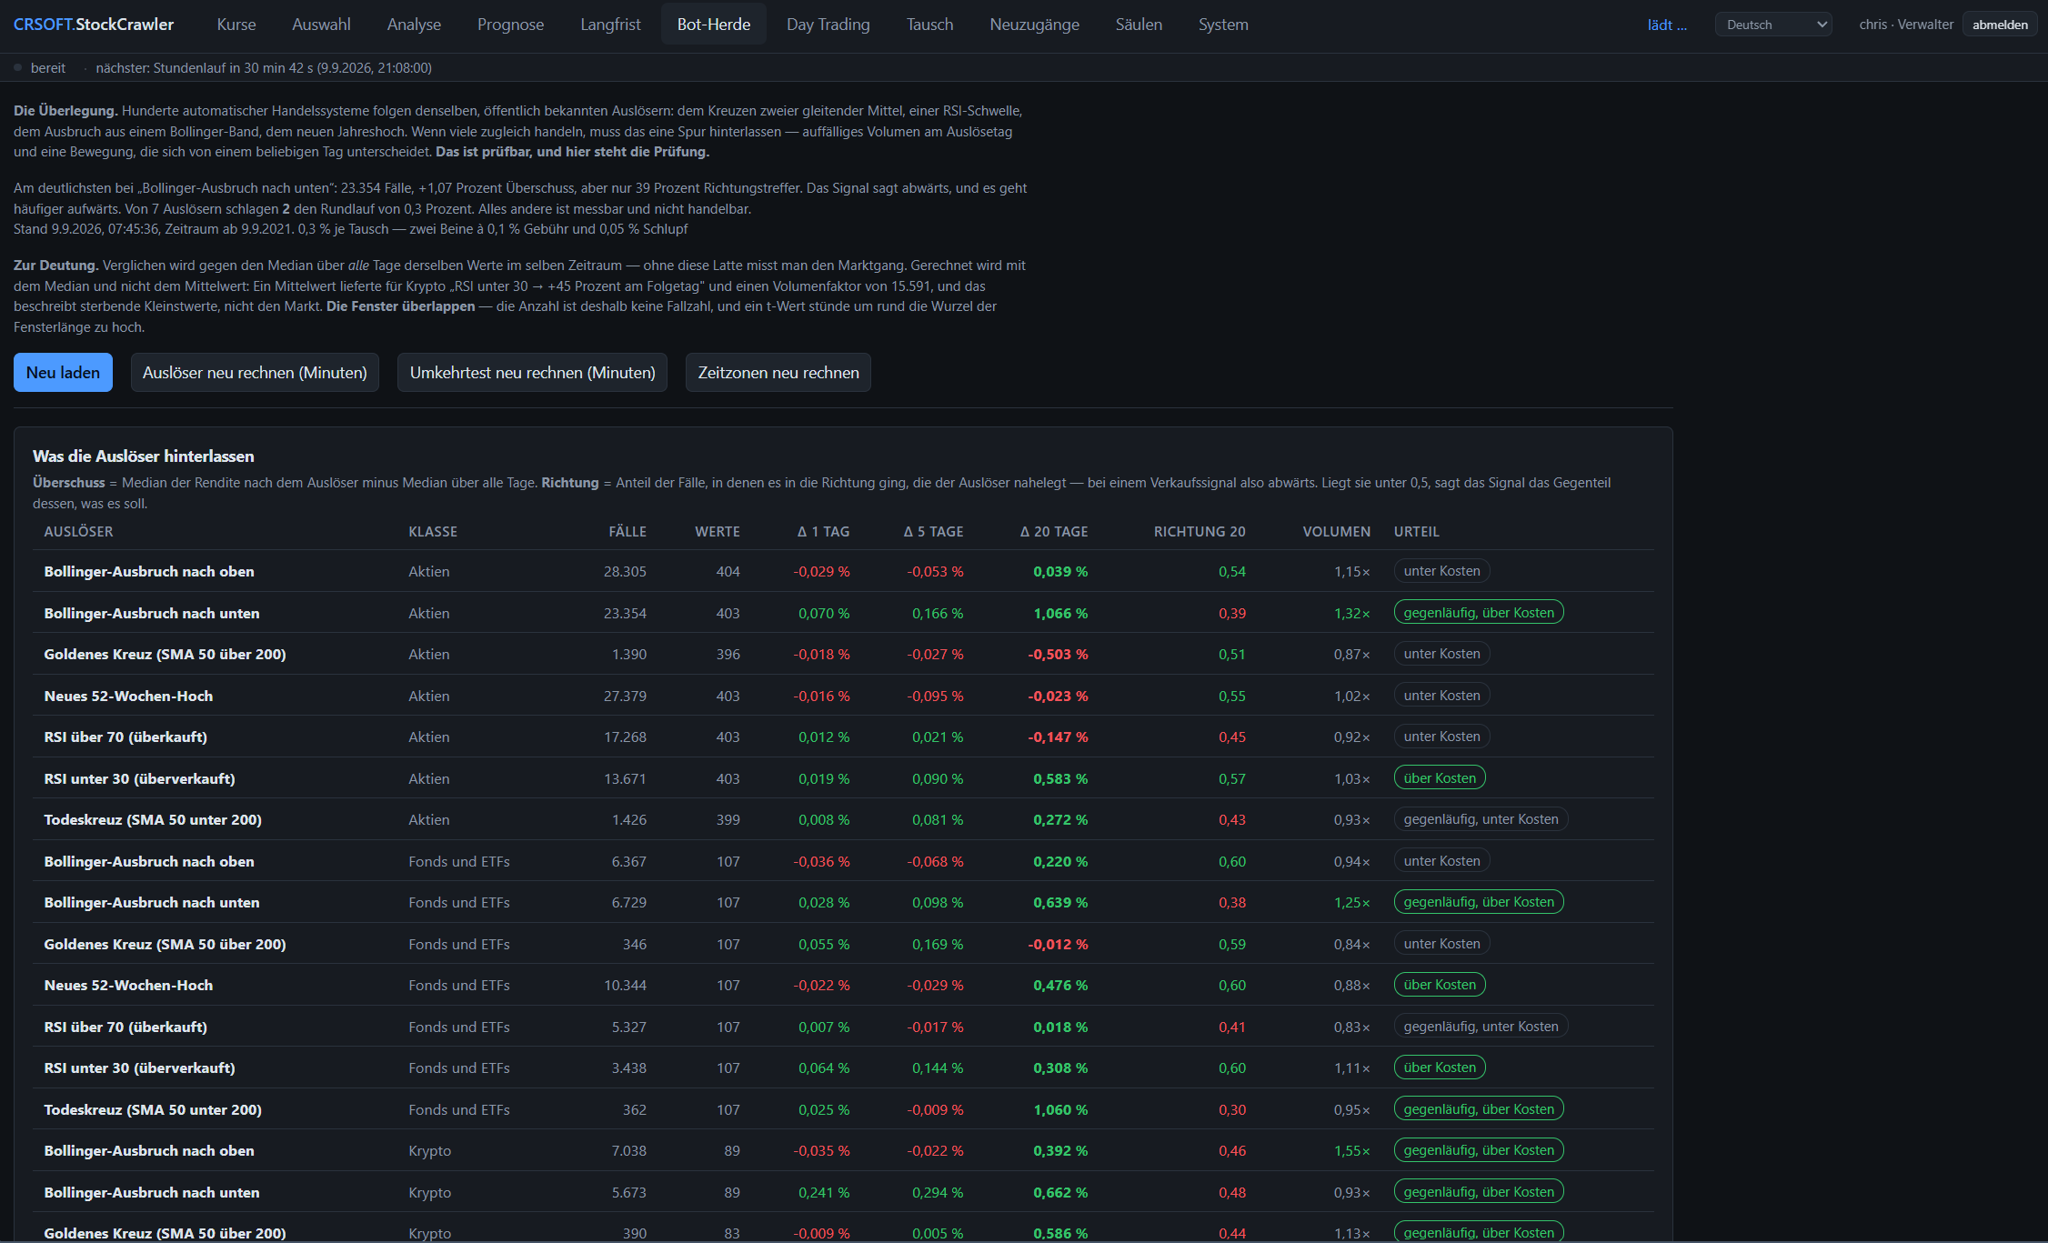
- Die Analyse der Bot-Herde misst über Tausende Ereignisse, was öffentlich bekannte Auslöser tatsächlich im Markt hinterlassen.
Die entscheidende Frage lautet dabei nie nur: Gibt es ein Muster? Sondern: Bleibt davon etwas übrig, wenn man es an Daten prüft, die das Verfahren vorher nicht gesehen hat?
35 Nachrichtenquellen – in jeder Sprache
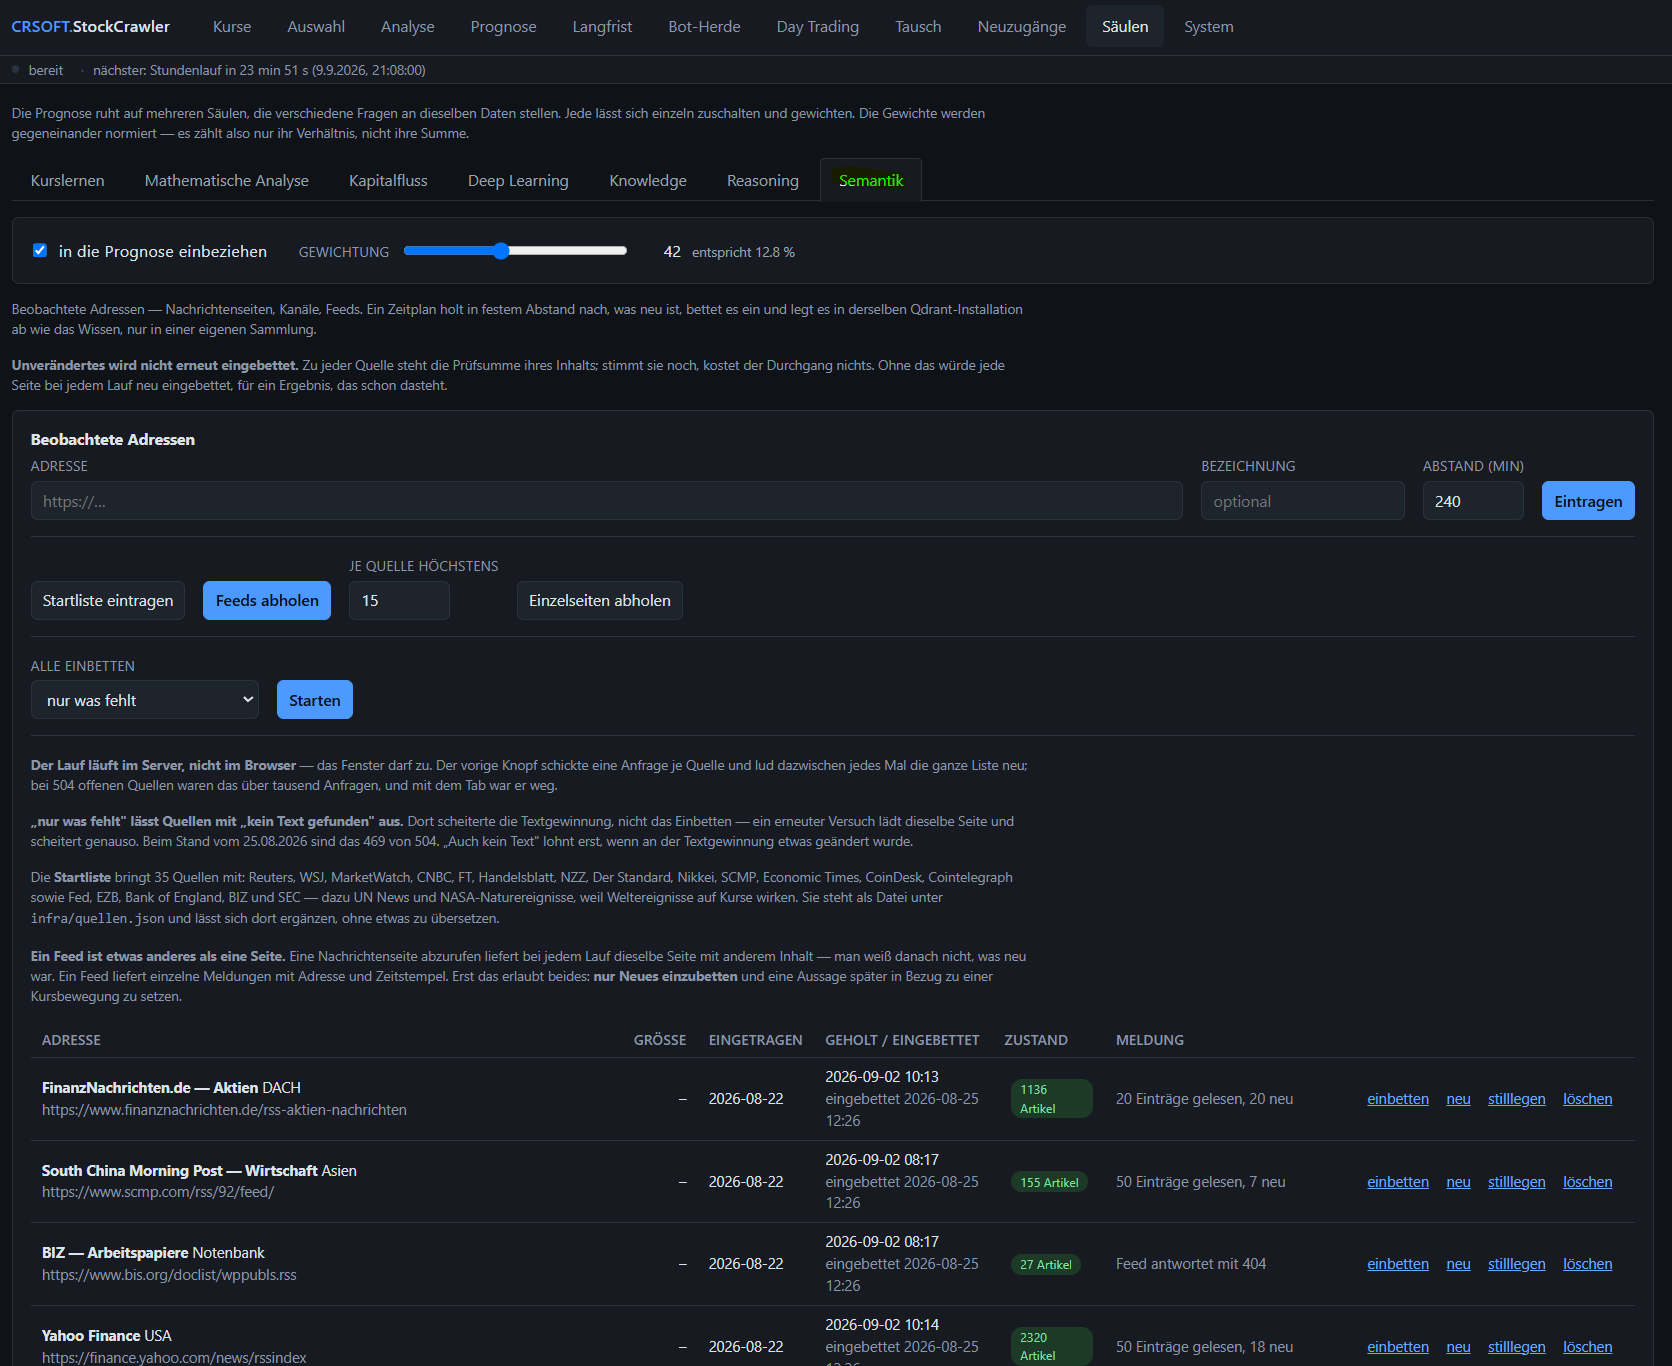
Parallel zu den Kursen liest das System stündlich Nachrichten ein. Aktuell sind es 35 Quellen aus elf Regionen und 11.644 Artikel.
Dazu gehören Reuters, WSJ, FT, CNBC, MarketWatch, Handelsblatt, NZZ, Der Standard, Nikkei, South China Morning Post, Economic Times, CoinDesk und Cointelegraph. Hinzu kommen Fed, EZB, Bank of England, BIZ und SEC sowie UN News für Weltereignisse.
Der entscheidende Punkt ist die Sprachunabhängigkeit. Das
Einbettungsmodell bge-m3 ist mehrsprachig: Eine deutsche
Frage findet auch eine japanische Meldung, ohne dass irgendwo übersetzt
wird. Es gibt keinen Übersetzungsschritt, weil keiner nötig ist – die
Vektoren liegen im selben Raum.
Soziale Kanäle sind derzeit noch nicht enthalten. Die Feed-Schicht kann grundsätzlich jede RSS- oder Atom-Quelle aufnehmen. Die technische Erweiterung ist also klein; die eigentliche Arbeit besteht darin, die Signalqualität zu messen.
Wenn die Nachricht von heute auf die Forschung von gestern trifft
Im selben Vektorraum liegt auch die Fachliteratur: 55 Quellen mit 42.219 Abschnitten, jeweils mit Quelle, Seite und Textanker.
Enthalten sind:
- 41 arXiv-Arbeiten zu Limit Order Books, statistischer Arbitrage, Marktwirkung, Ausführungsstrategien und Deep Learning im Handel,
- 12 gemeinfreie Klassiker, darunter Lefèvre, Selden, Harper, Clews, Crump, Gibson, Lawson, Rice, Brandenburg, Butler und Francis,
- eine Dissertation zu Marktmikrostruktur und algorithmischem Handel,
- ein BIZ-Arbeitspapier zum Hochfrequenzhandel.
Nachrichten und Literatur liegen nicht in getrennten Silos. Eine Frage nach Verlustaversion findet die passende Stelle im Lehrbuch und zugleich die Meldung von heute Morgen – ohne dass jemand diese Verbindung von Hand angelegt hätte.
NVIDIA Nemotron: Erklärer statt Orakel
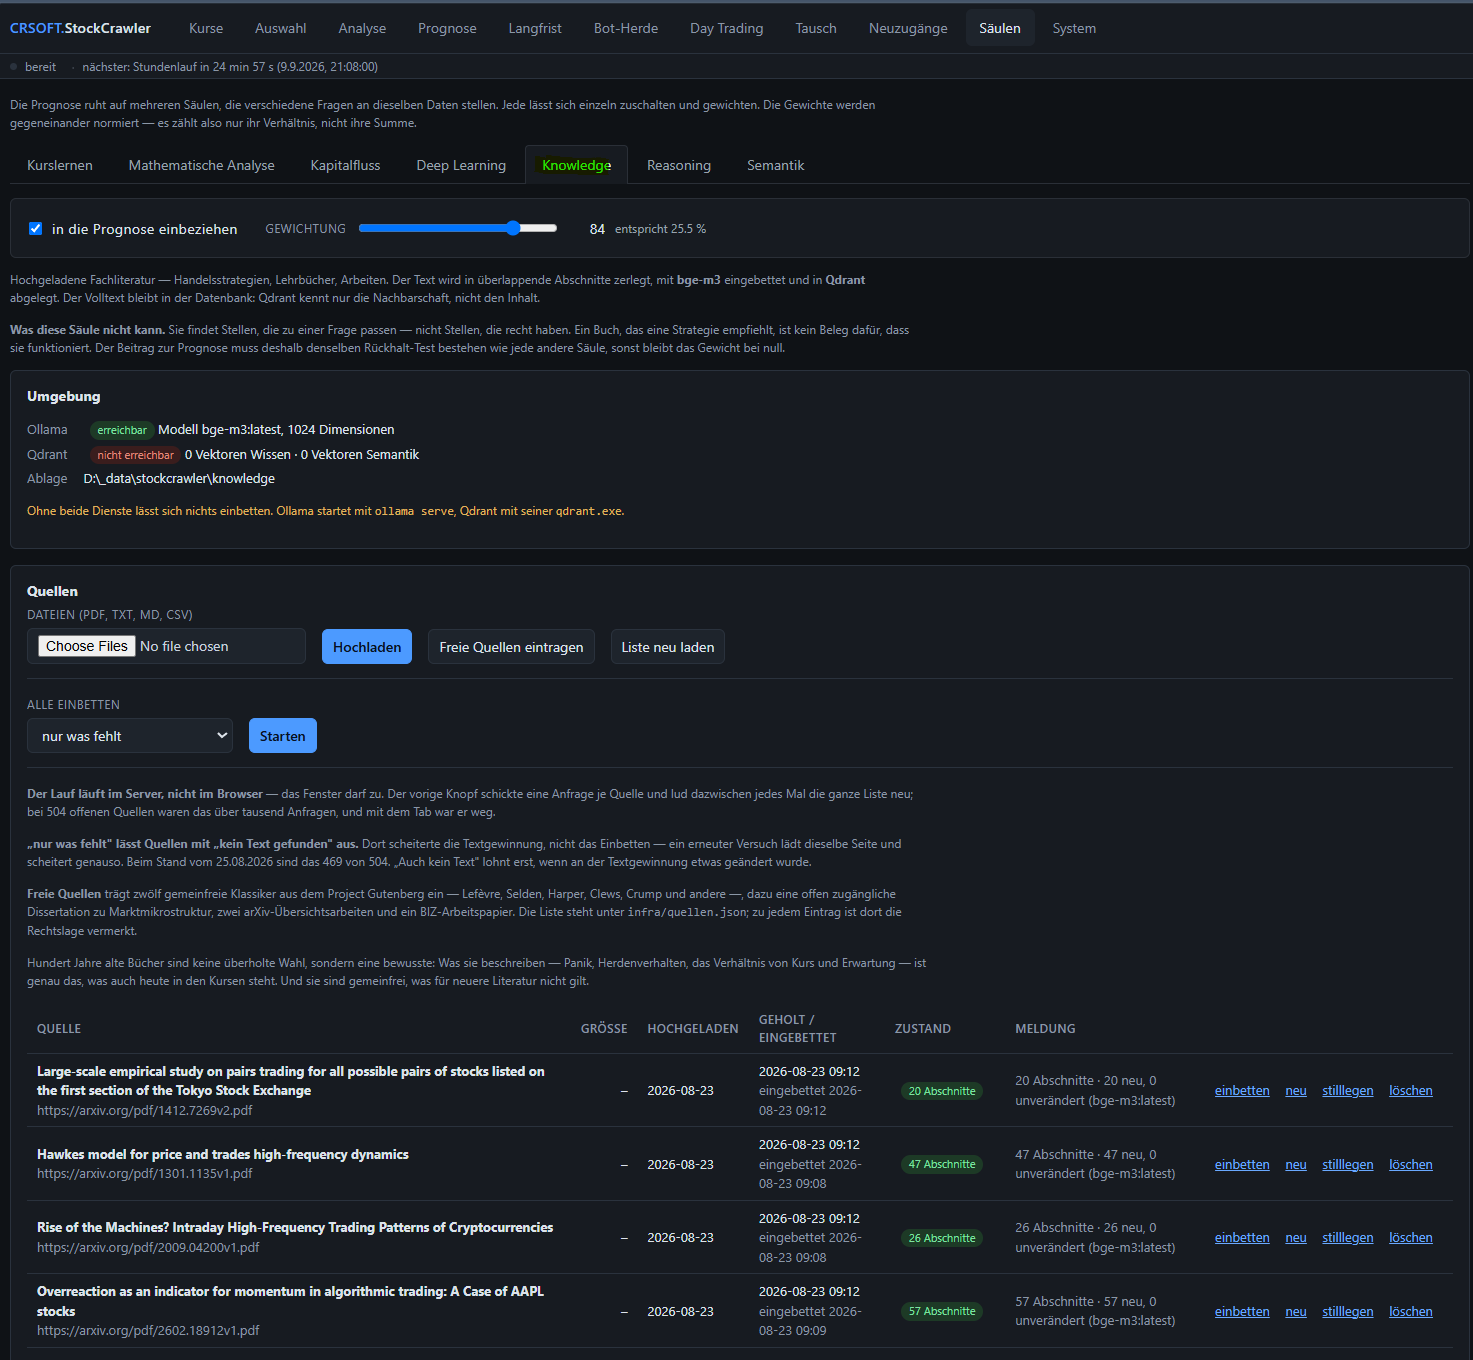
nemotron3:33b beantwortet Fragen zu Prognosen,
Kurvenereignissen, Verknüpfungen und dem gesammelten Wissen. Dabei gilt
eine harte Regel: Das Modell darf keine Zahl
erfinden.
Jede Zahl stammt aus einem Werkzeugaufruf. Name, Argumente und Ergebnis dieses Aufrufs stehen unter jeder Antwort. Wer einer Aussage misstraut, kann nachsehen.
Nemotron antwortet in der Sprache der Frage. Es ist dabei ausdrücklich Erklärer, nicht Orakel: Das Modell liest vorhandene Prognosen, ordnet sie ein und erklärt Zusammenhänge. Es erzeugt die Prognosen nicht selbst. Deshalb hat die Reasoning-Säule auch kein Gewicht am Ergebnis.
Was jeden Tag entsteht
Das System hat inzwischen 978.837 Live-Prognosen über sieben Horizonte erzeugt – von 24 Stunden bis zu einem Jahr. 303.465 davon wurden bereits gegen den später tatsächlich eingetroffenen Kurs ausgewertet.
Täglich entstehen daraus:
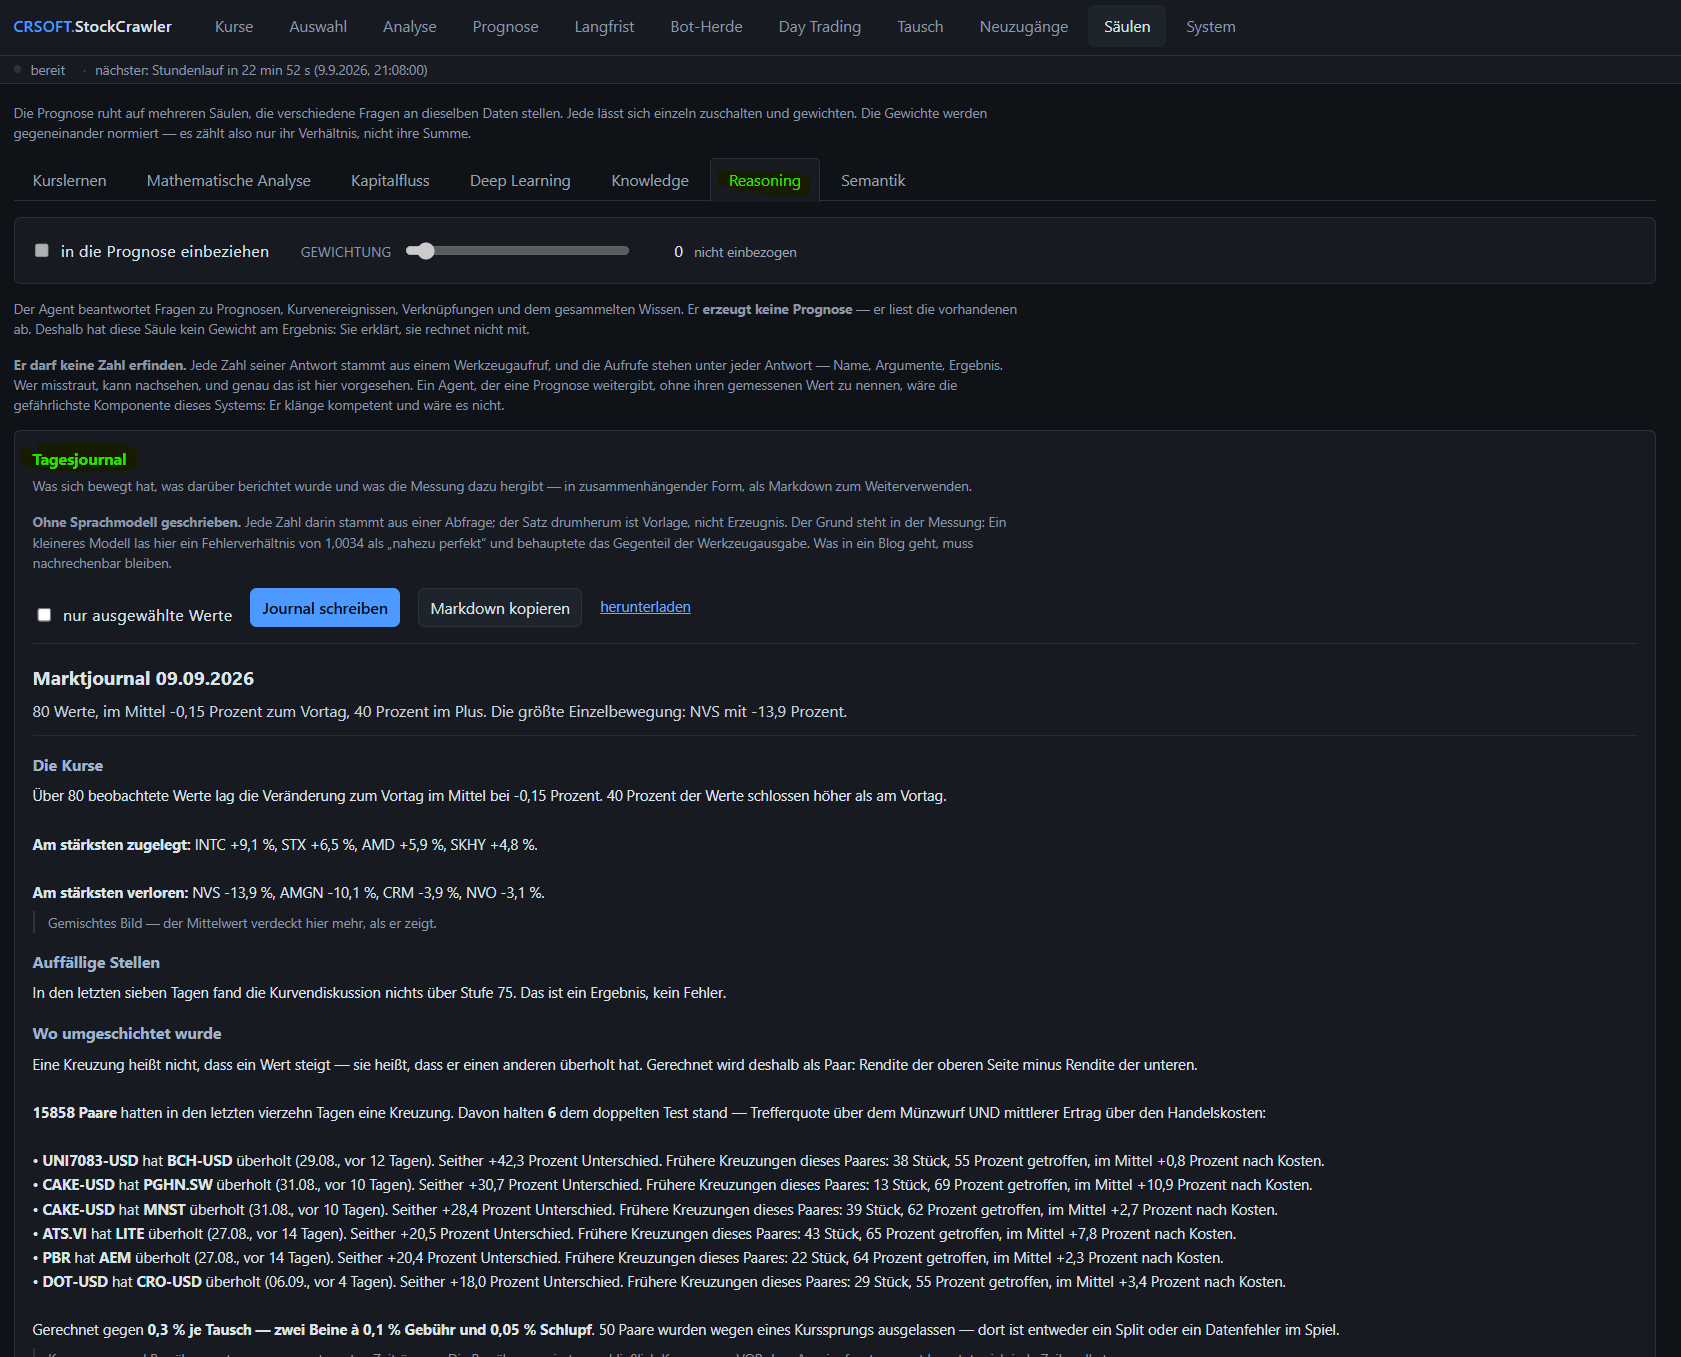
- ein Marktjournal, das zusammenführt, was sich bewegt hat, was darüber berichtet wurde und was die Messung dazu hergibt,
- eine Tagesübersicht der auffälligen Stellen, gewichtet nach Auffälligkeit mal gemessenem Verdienst der jeweiligen Säule,
- Trends, Auffälligkeiten und Prognosen mit ihrer sichtbaren Güte.
Das Journal wird bewusst ohne Sprachmodell geschrieben. Jede Zahl stammt aus einer Abfrage; der Satz darum ist eine Vorlage und kein frei erzeugter Text.
Der Grund dafür ist sehr konkret: Ein kleineres Modell interpretierte einmal ein Fehlerverhältnis von 1,0034 als „nahezu perfekt“ und behauptete damit das Gegenteil der Werkzeugausgabe. Was in ein Journal oder einen Blog gelangt, muss nachrechenbar bleiben.
Der wichtigste Teil: Was davon trägt wirklich?
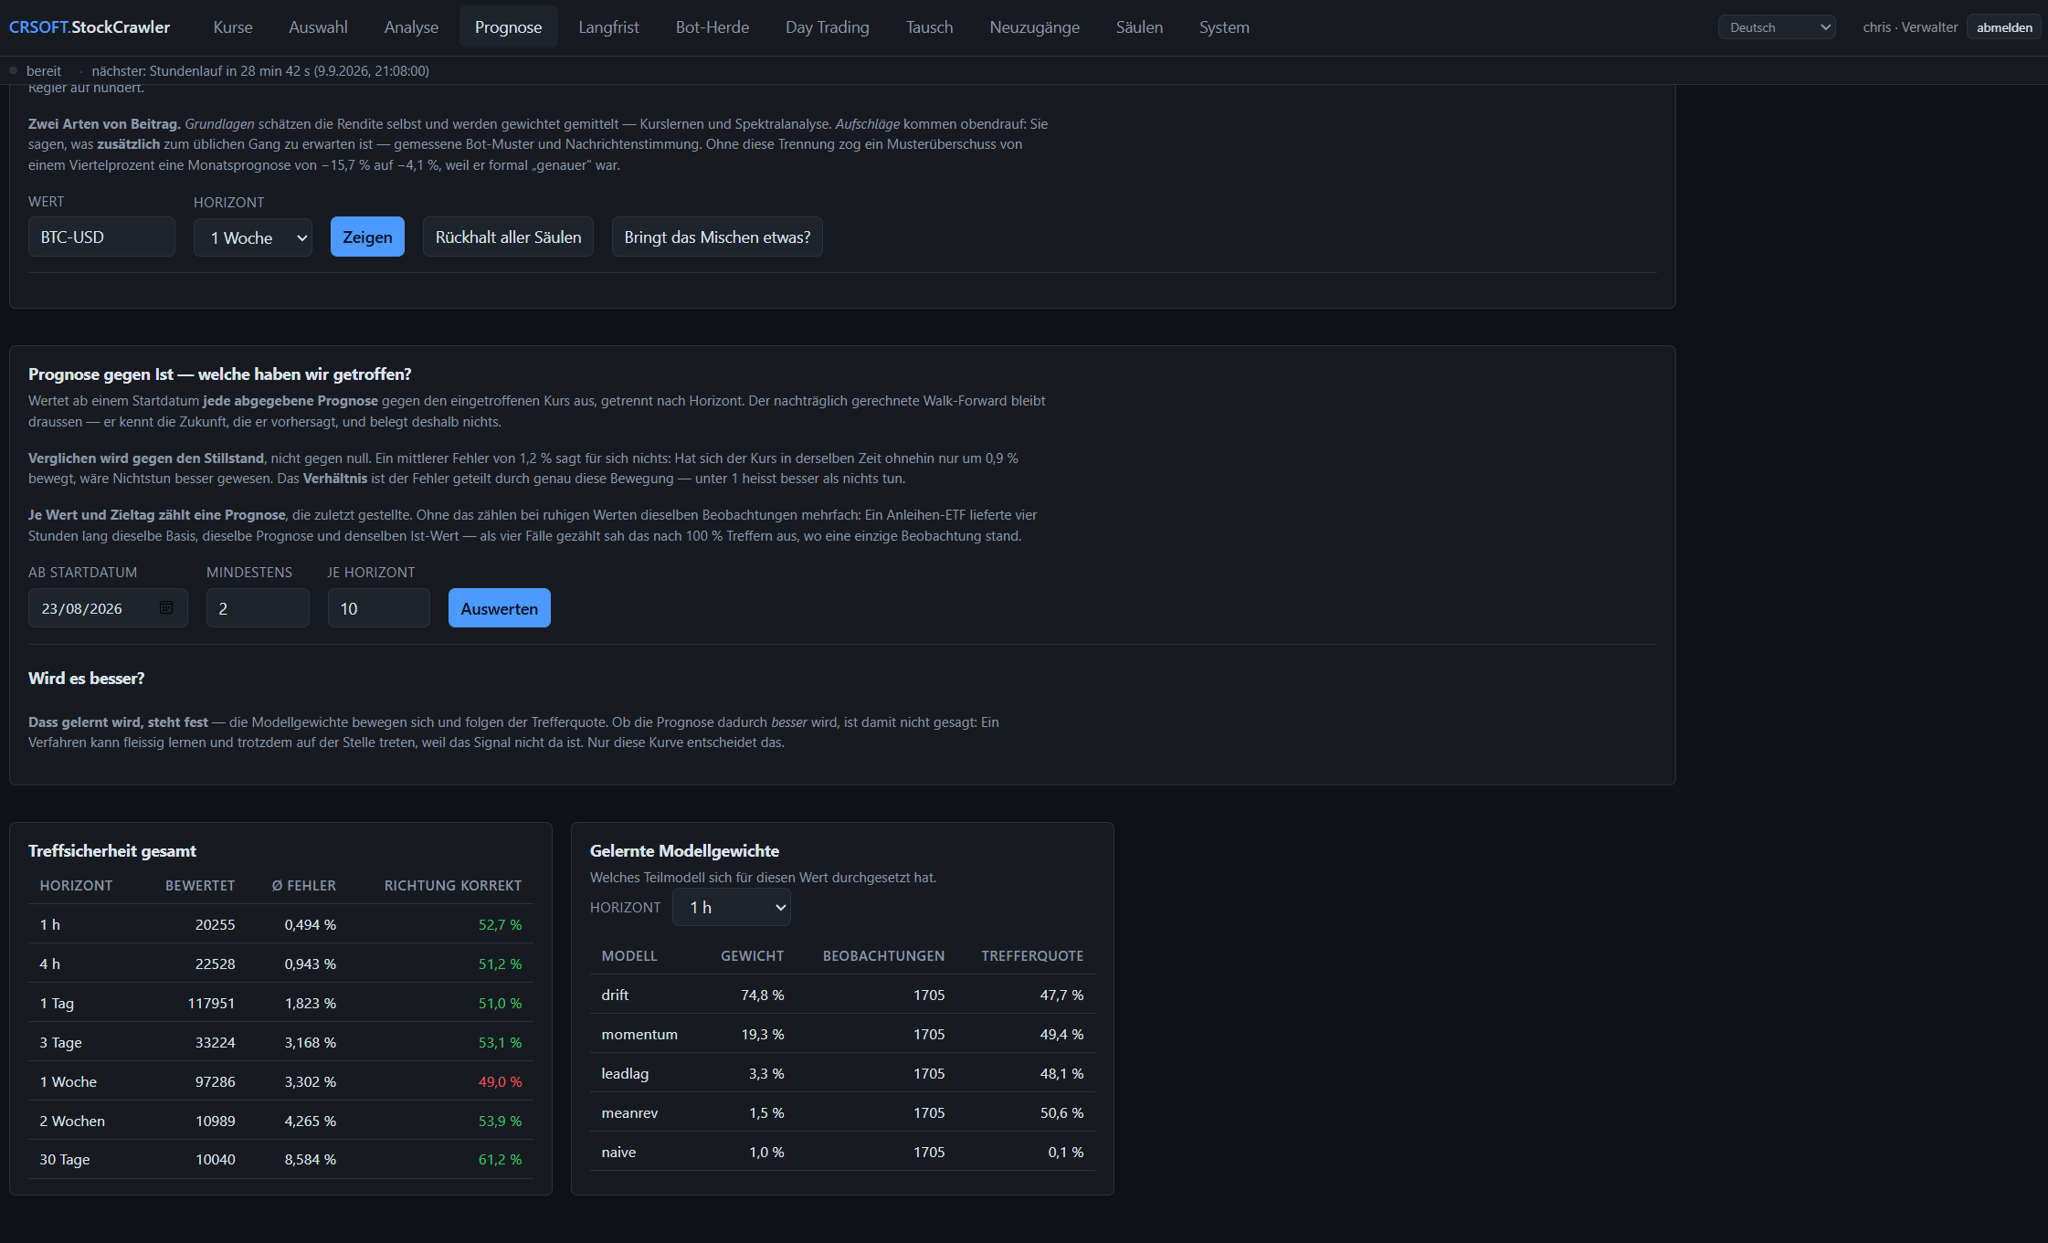
Jede Prognose wird gegen den Kurs ausgewertet, der tatsächlich eingetroffen ist. Nicht in einer Rückrechnung, sondern gegen Kurse, die kein Modell dieser Anwendung je gesehen hat.
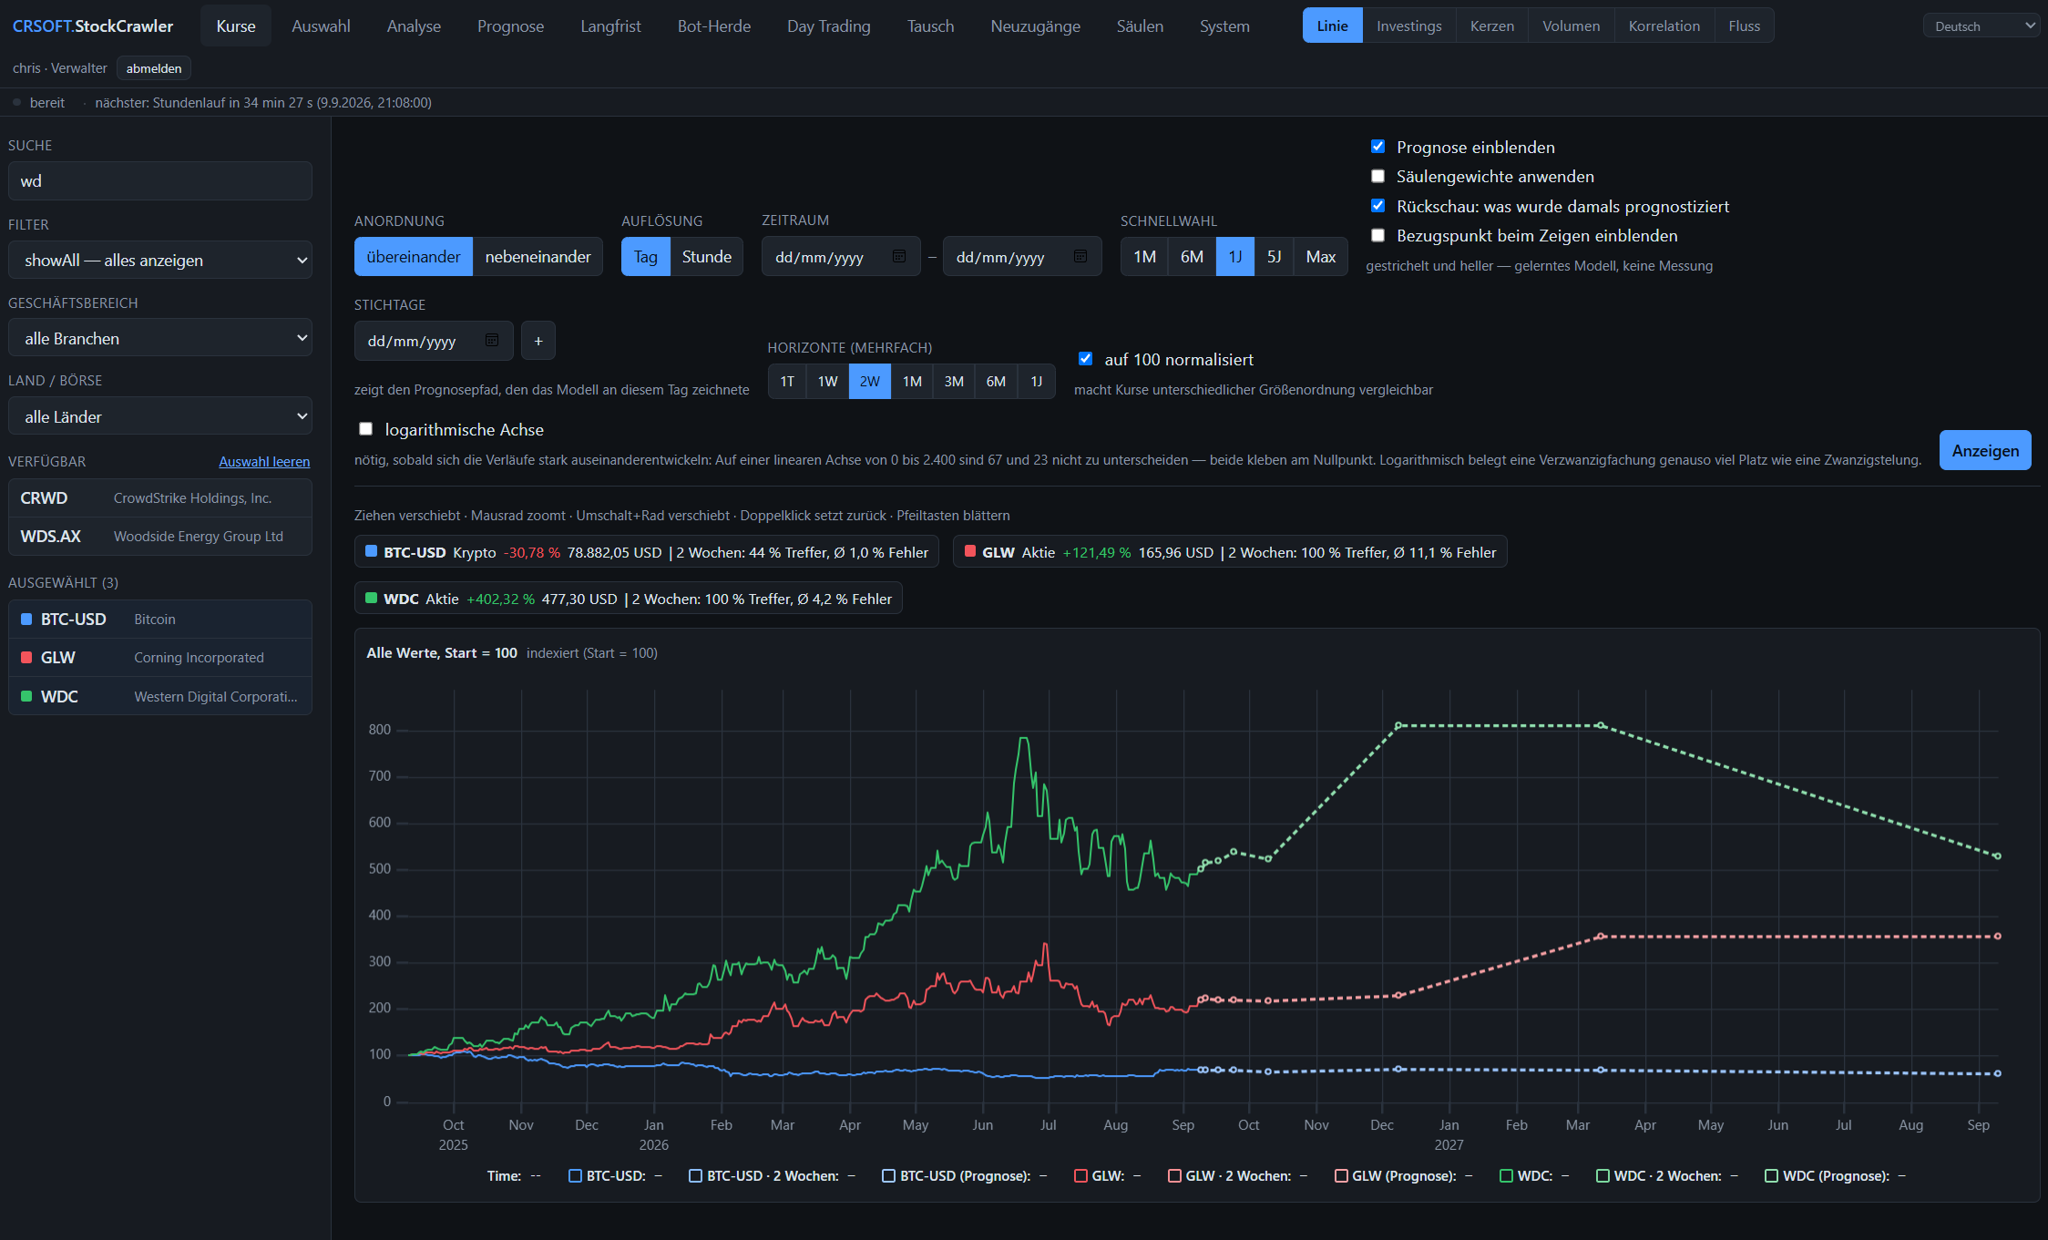
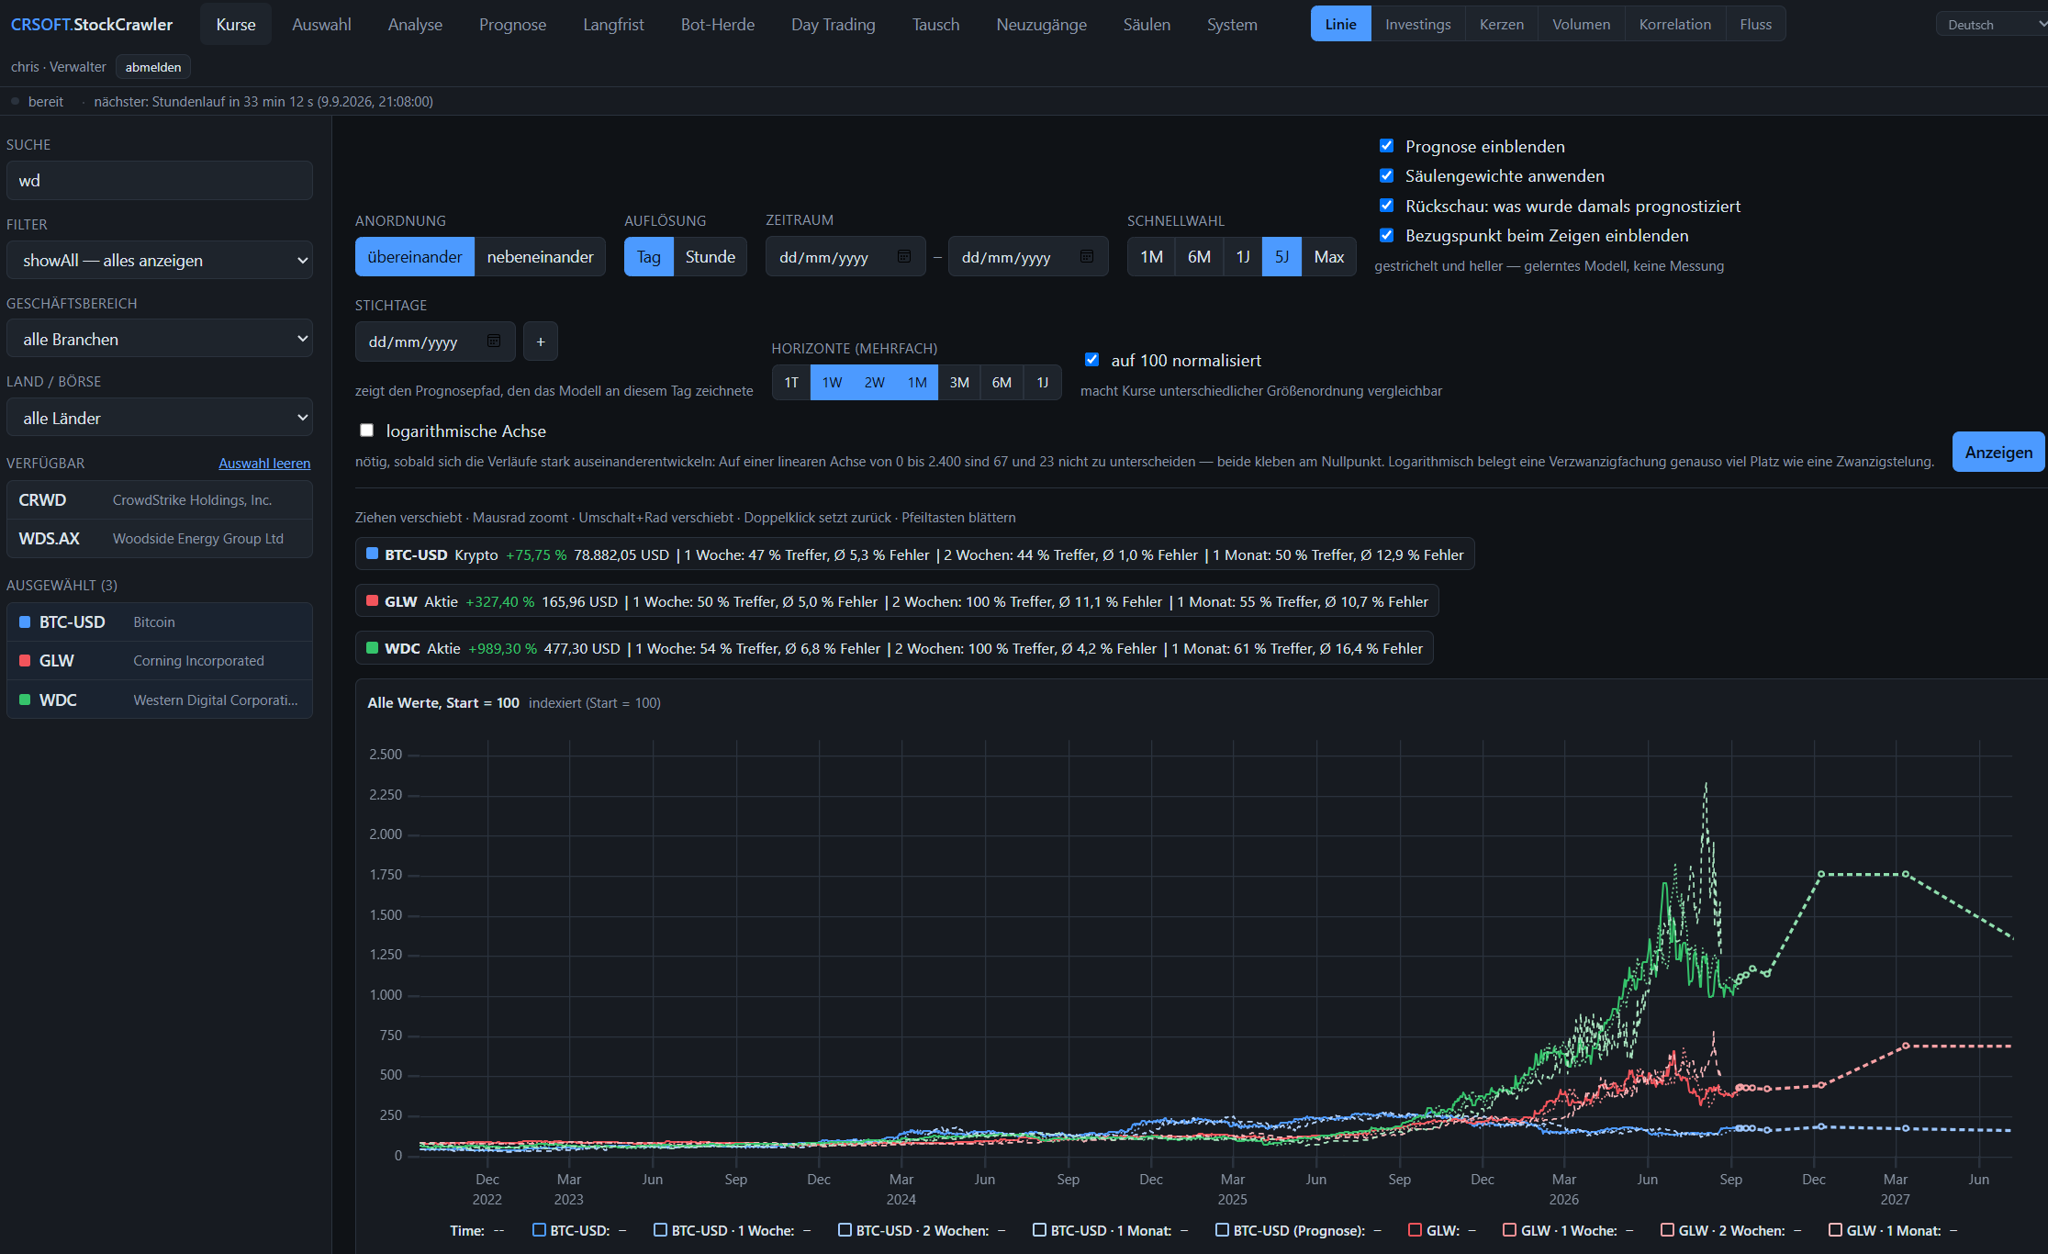
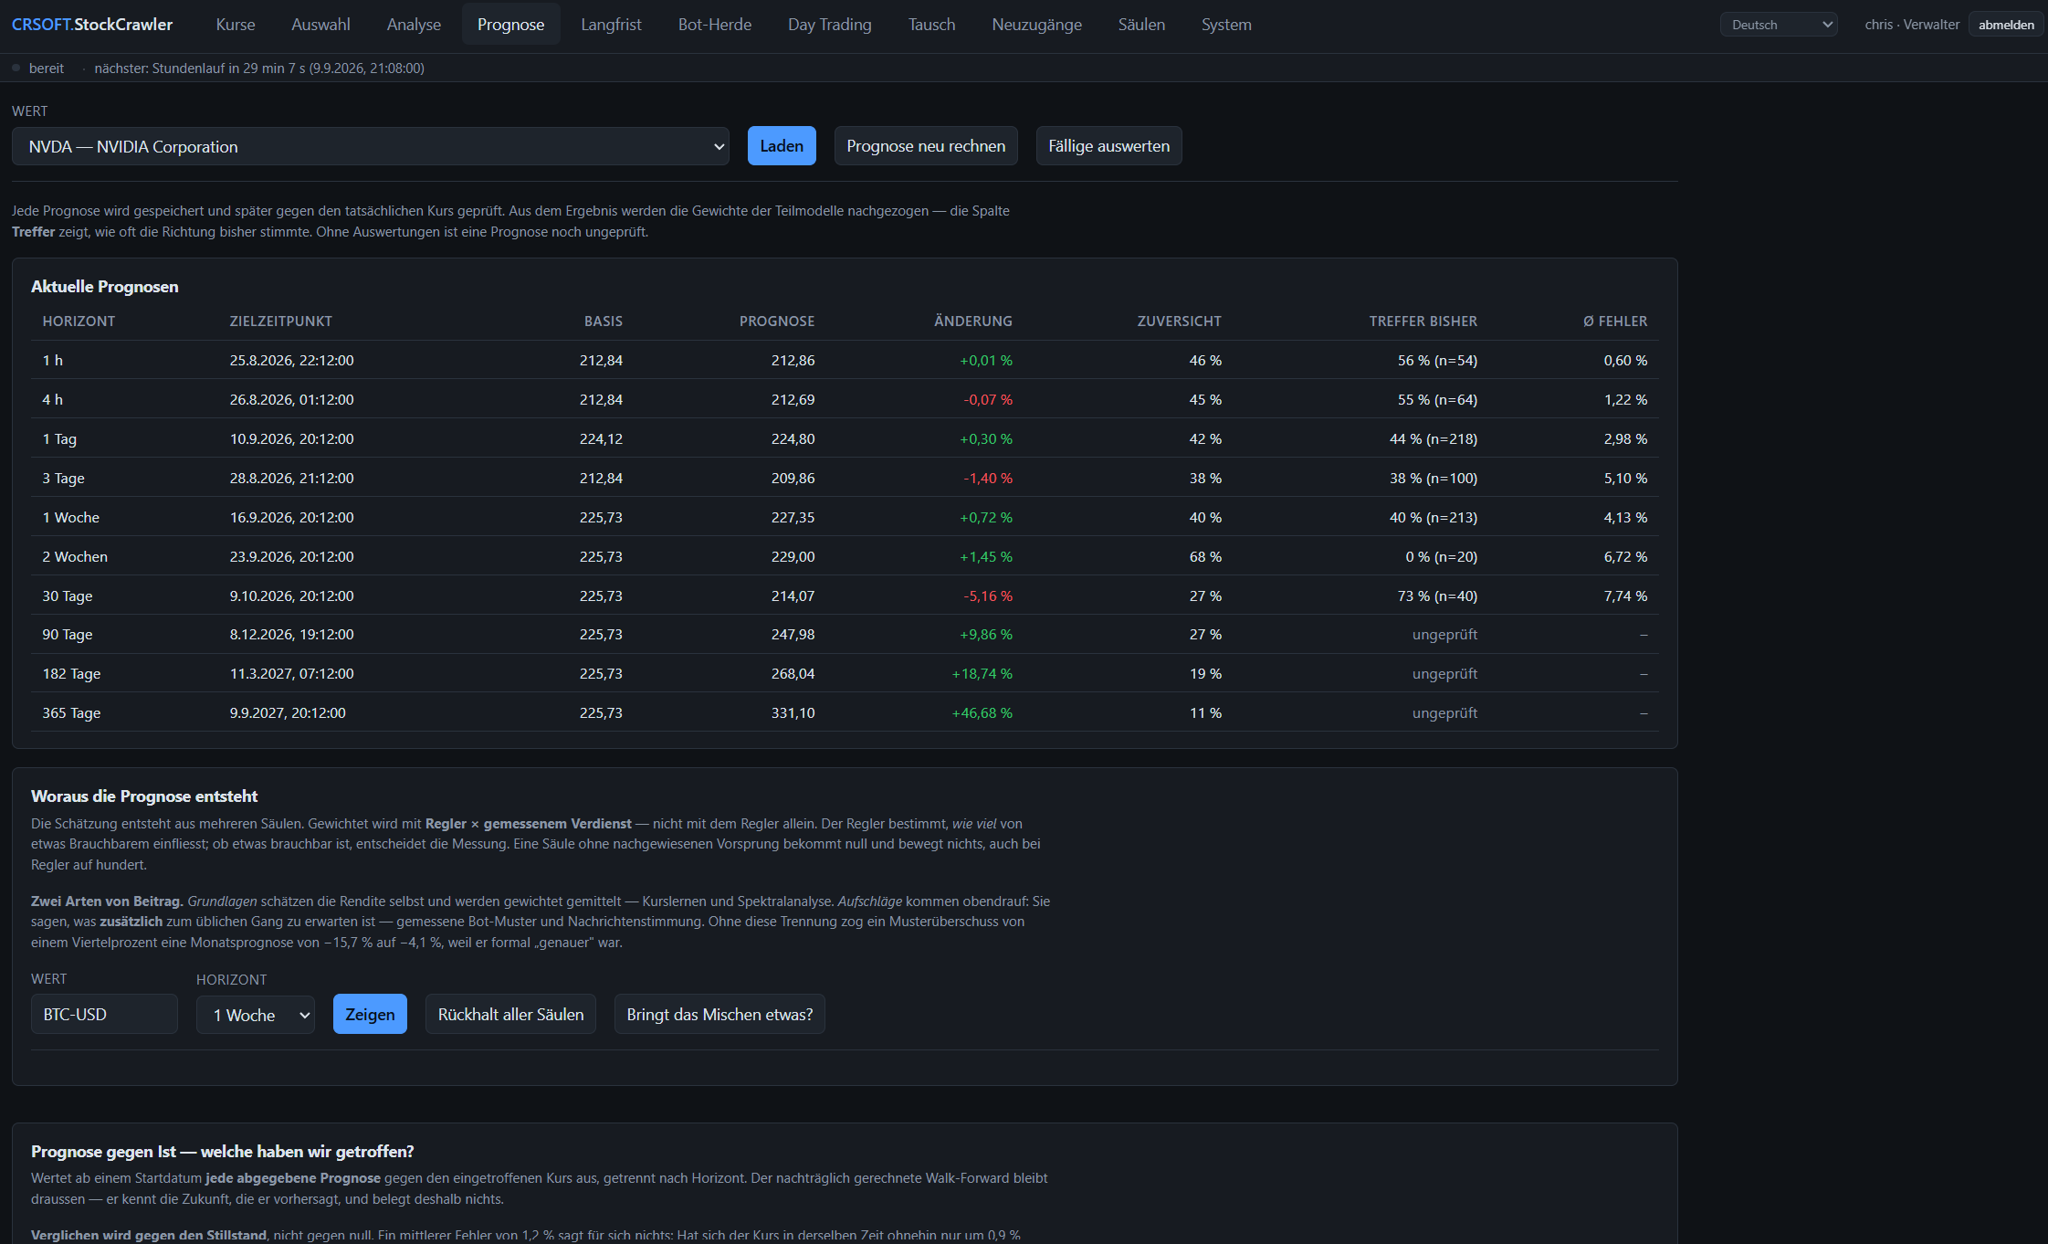
Trefferquote, Fehlerverhältnis und Erwartungswert nach Kosten stehen je Wert und je Horizont direkt in der Oberfläche – neben der Prognose, auf die sie sich beziehen.
Das ist auch der Grund, warum CRSOFT.StockCrawler keine Kaufempfehlungen gibt. Wer die gemessene Güte einer Prognose direkt daneben sieht, braucht keine fertige Empfehlung. Er kann seine eigene Entscheidung treffen – auf einer Grundlage, die sich nachrechnen lässt.
Acht Säulen, aber kein Gewicht ohne Nachweis
Jede der acht Säulen stellt eine andere Frage an dieselben Daten. Jede lässt sich zuschalten und gewichten. Doch keine bewegt etwas ohne gemessenen Rückhalt.
Gewichtet wird mit Regler × Verdienst. Der Verdienst kommt aus dem Sperrbereich – nicht aus der Einstellung.
| Säule | Aufgabe |
|---|---|
| Kurslernen | Fünf Teilmodelle, deren Gewichte laufend aus dem eigenen Fehler nachgezogen werden. Die einzige Säule, die derzeit in die gespeicherten Prognosen einfließt. |
| Mathematische Analyse | Spektrum, Zyklenstabilität, Momentanzyklus, SSA und Hurst – Signalverarbeitung auf der einzelnen Reihe. |
| Kapitalfluss | Umverteilung gegen Zu- und Abfluss, Rotationsverdacht und Gruppen mit erhaltener Summe. |
| Deep Learning | Drei ONNX-Modelle über getrennte Horizontbänder, im Prozess auf der CPU. |
| Wissen | Eingebettete Fachliteratur und gemessene Bot-Muster als Beitrag. |
| Semantik | Nachrichtenstimmung, kalibriert gegen die danach eingetroffene Rendite. |
| Reasoning | Erklärt, rechnet aber nicht mit. |
| Kurvendiskussion | Hoch-, Tief-, Wende- und Sattelpunkte über lokale Polynomanpassung. |
Von der Analyse bis zum virtuellen Depot
CRSOFT.StockCrawler bleibt nicht bei Korrelationen und Prognosen stehen. Die Anwendung untersucht auch, wie sich Signale unter realistischeren Bedingungen verhalten.
Analyse
- Korrelationen und Frühindikatoren über 397.011 ausgewertete Paare, einschließlich bestem Lag und Richtung
- Kreuzungen normalisierter Kurven mit Rangliste nach Paargewinn und Bewährung aus getrennten Zeiträumen
- Kurvendiskussion über den gesamten Bestand, kausal oder zentriert geglättet, mit Verknüpfung gleichzeitiger Ereignisse
- Weltbestand und Zeitzonen mit sauberer Trennung von Vorlauf und bloßer Überlappung
- Bot-Herde: messbare Spuren öffentlich bekannter Auslöser wie gleitender Mittel, RSI und Bollinger
- Umkehrschluss: Taugt ein Signal vielleicht dann, wenn man es umdreht?
Prognose und Güte
- sieben Horizonte, je Wert und Zieltag genau eine entdoppelte Beobachtung
- Lernkurve: Wird das System tatsächlich besser?
- Mischvergleich: Bringt das Zusammenführen der Säulen überhaupt etwas?
- Rückblick als aufsummierter Vorsprung gegenüber dem Stillstand
Handel und Depot
- Day Trading: nicht „Was soll ich kaufen?“, sondern: Trägt der Markt heute überhaupt einen Handel innerhalb des Tages, nachdem Gebühren abgezogen wurden?
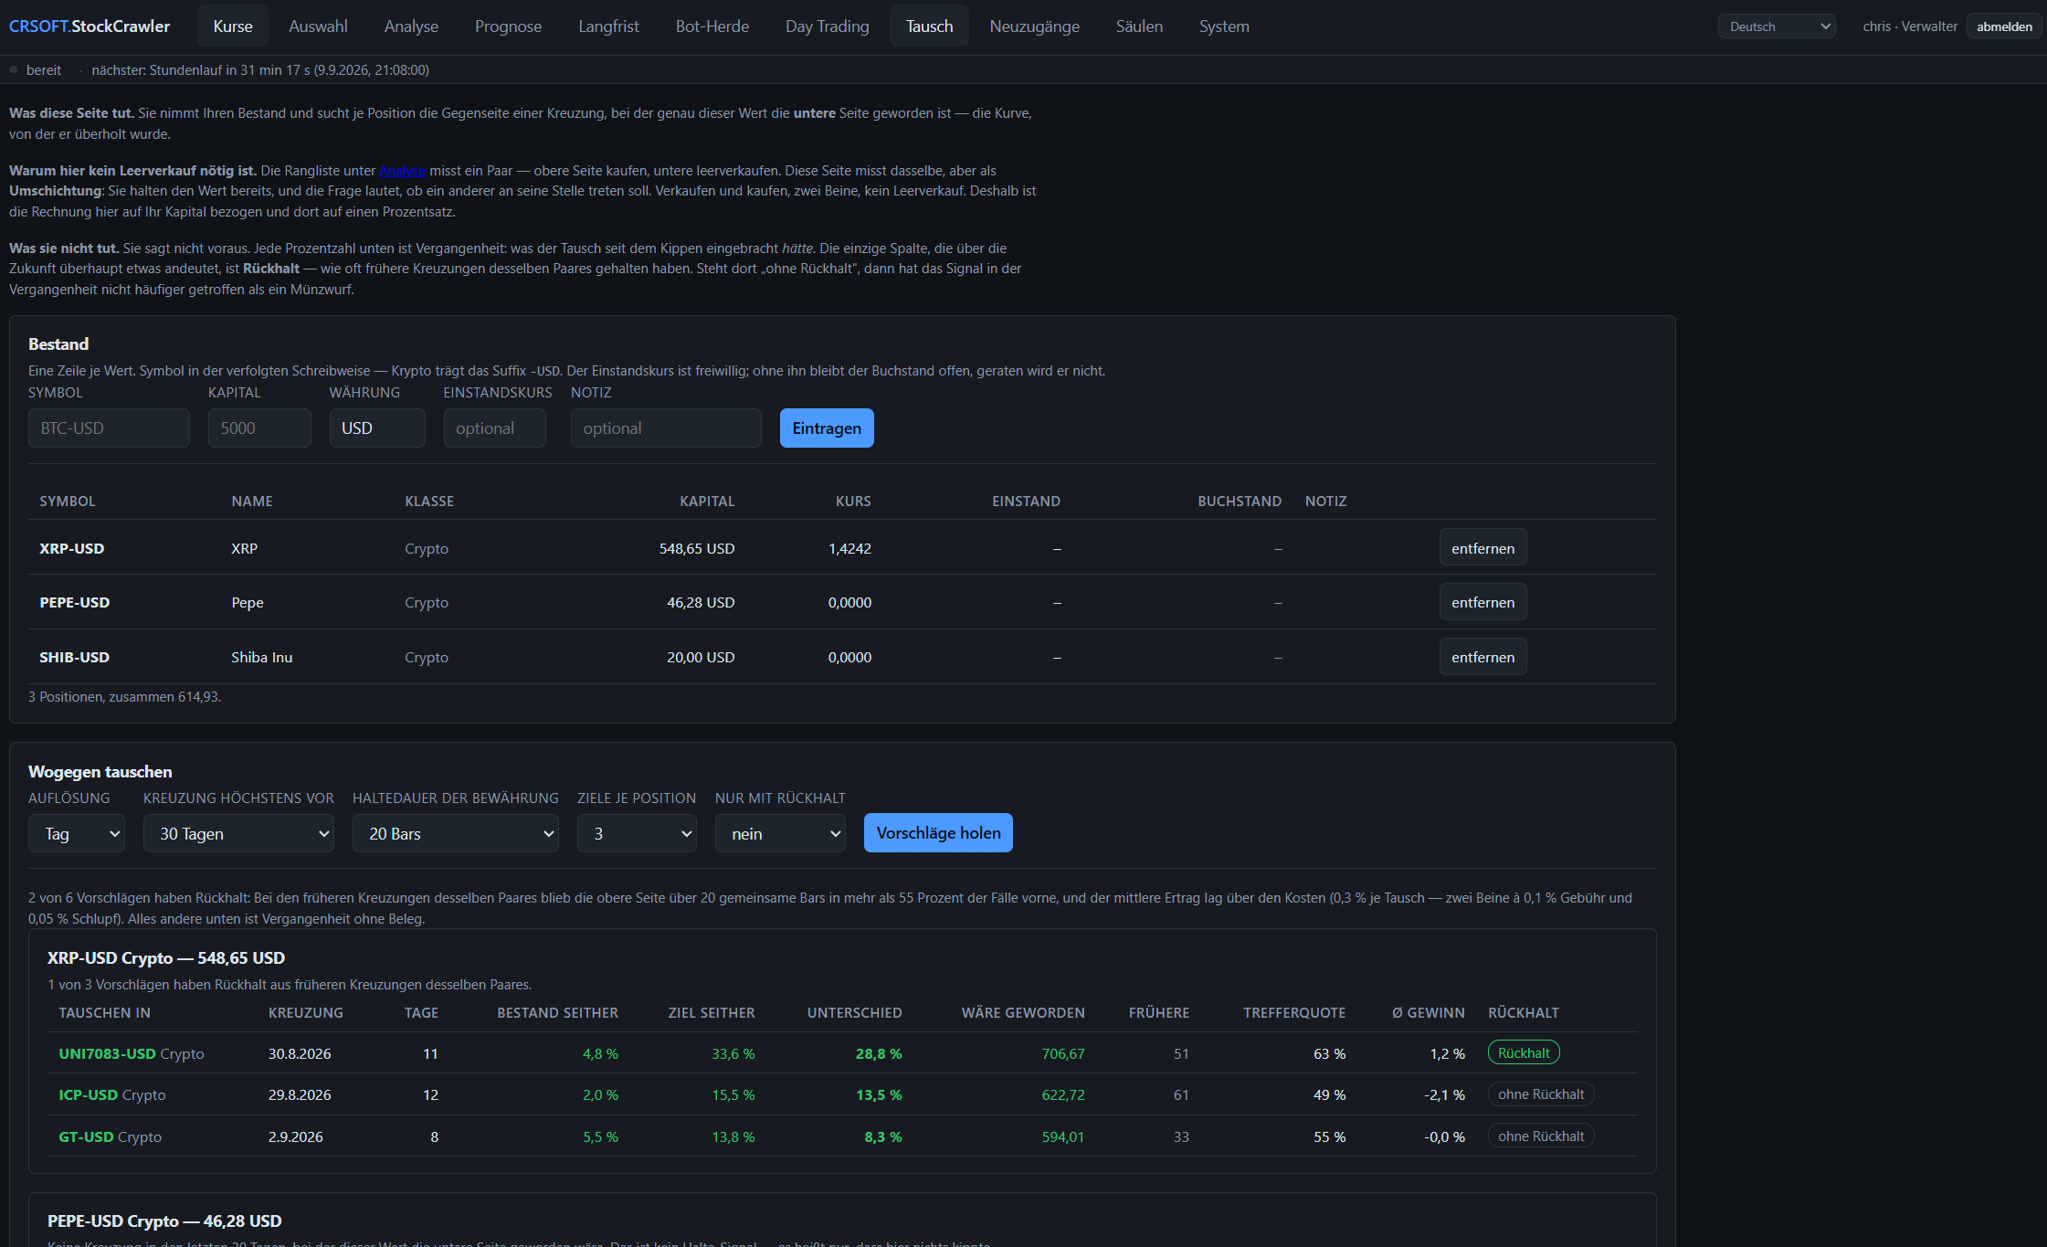
- Tausch: Umschichtungsvorschläge bezogen auf den eigenen Bestand
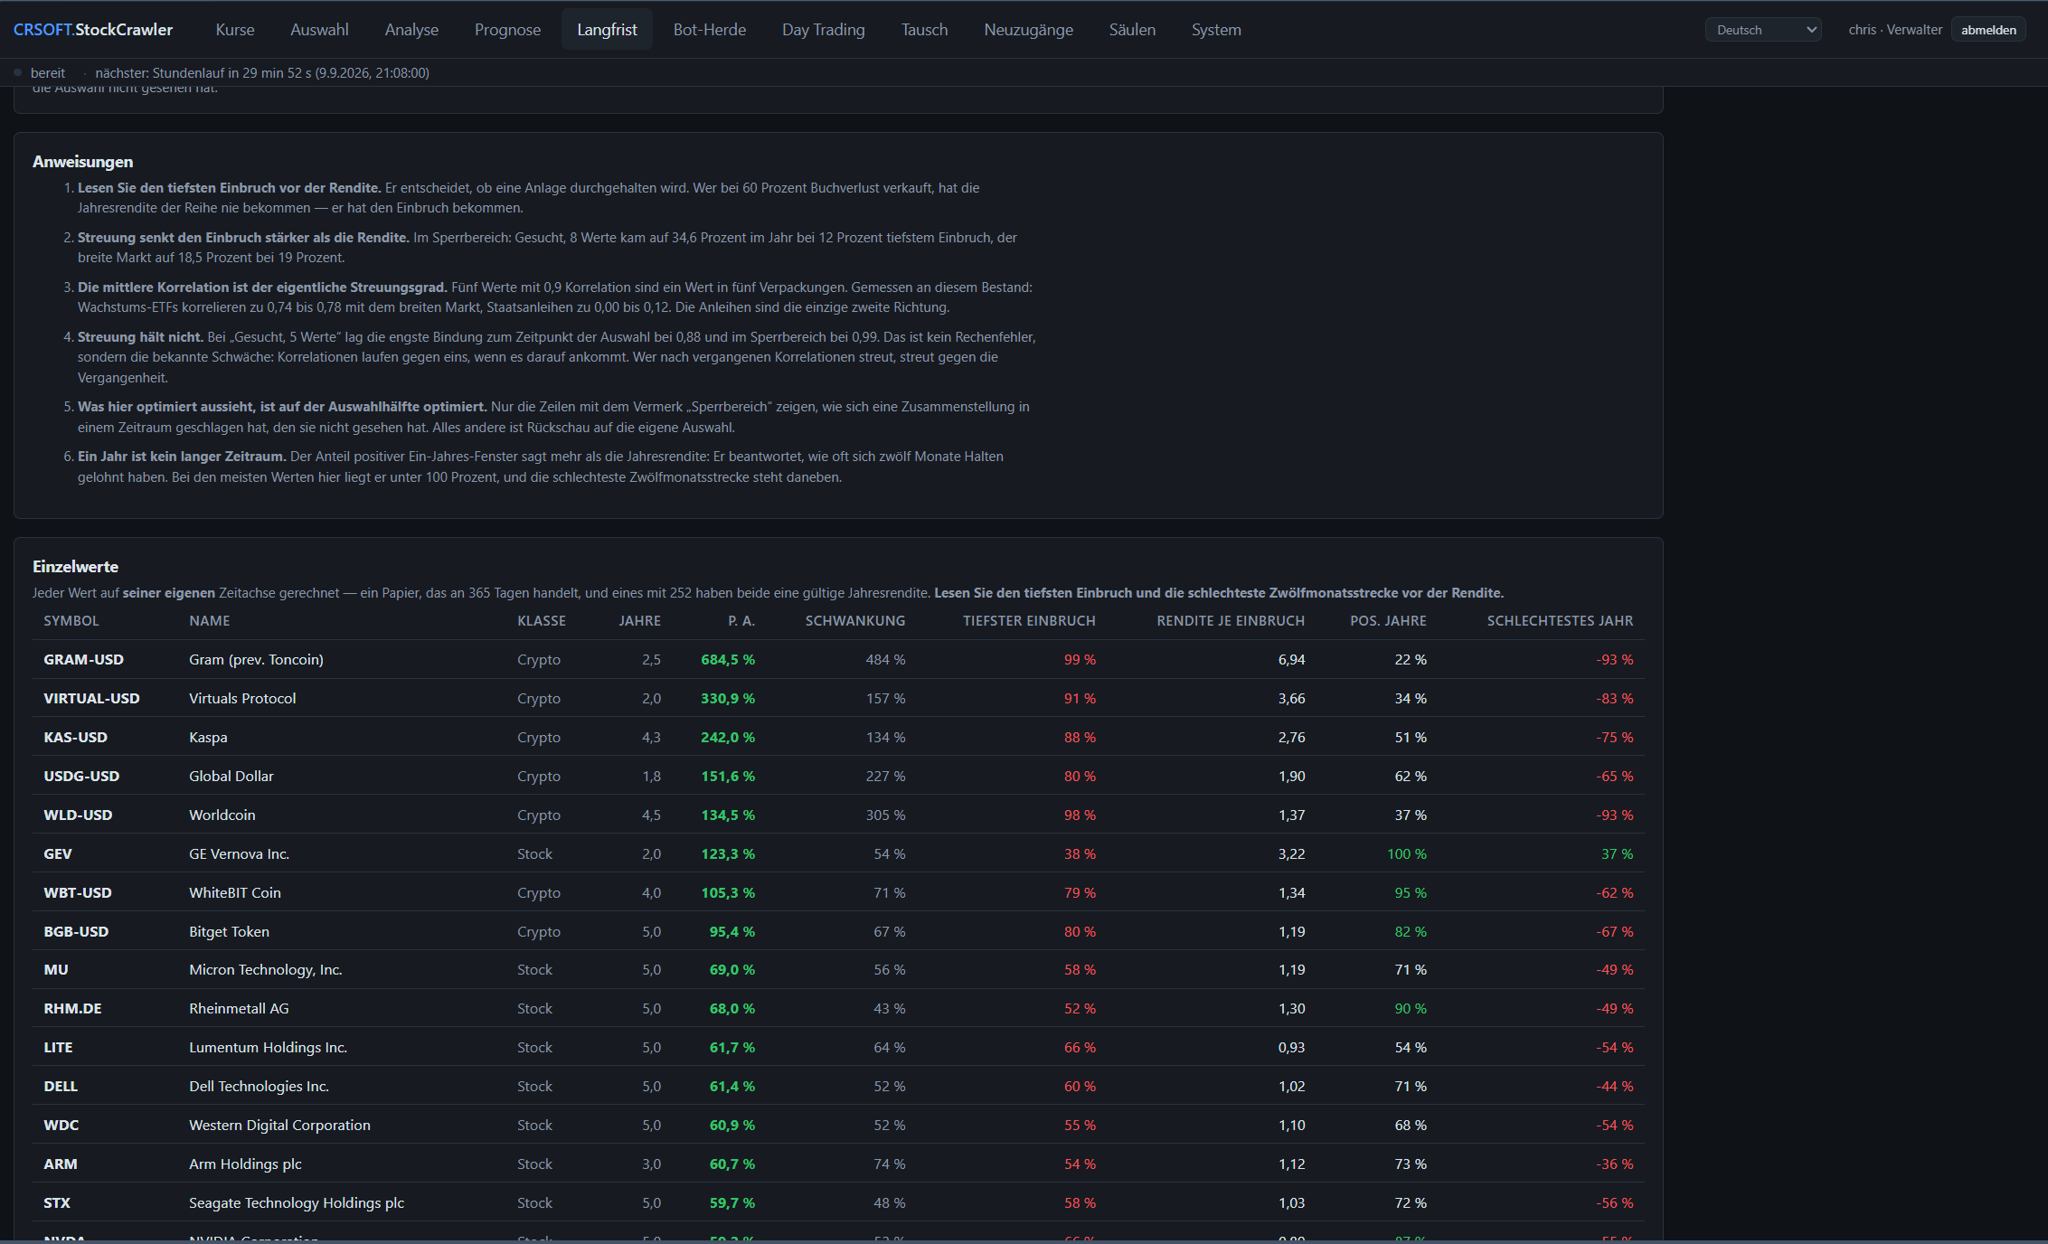
- Langfrist: Renditen, tiefste Einbrüche und Körbe – mit sichtbarer Überlebensverzerrung
- Virtuelles Depot: Verrechnungskonten in EUR und USD, Gebühren je Vorgang, Buchungsjournal und Vermögensverlauf
- Autopilot mit vier Strategien:
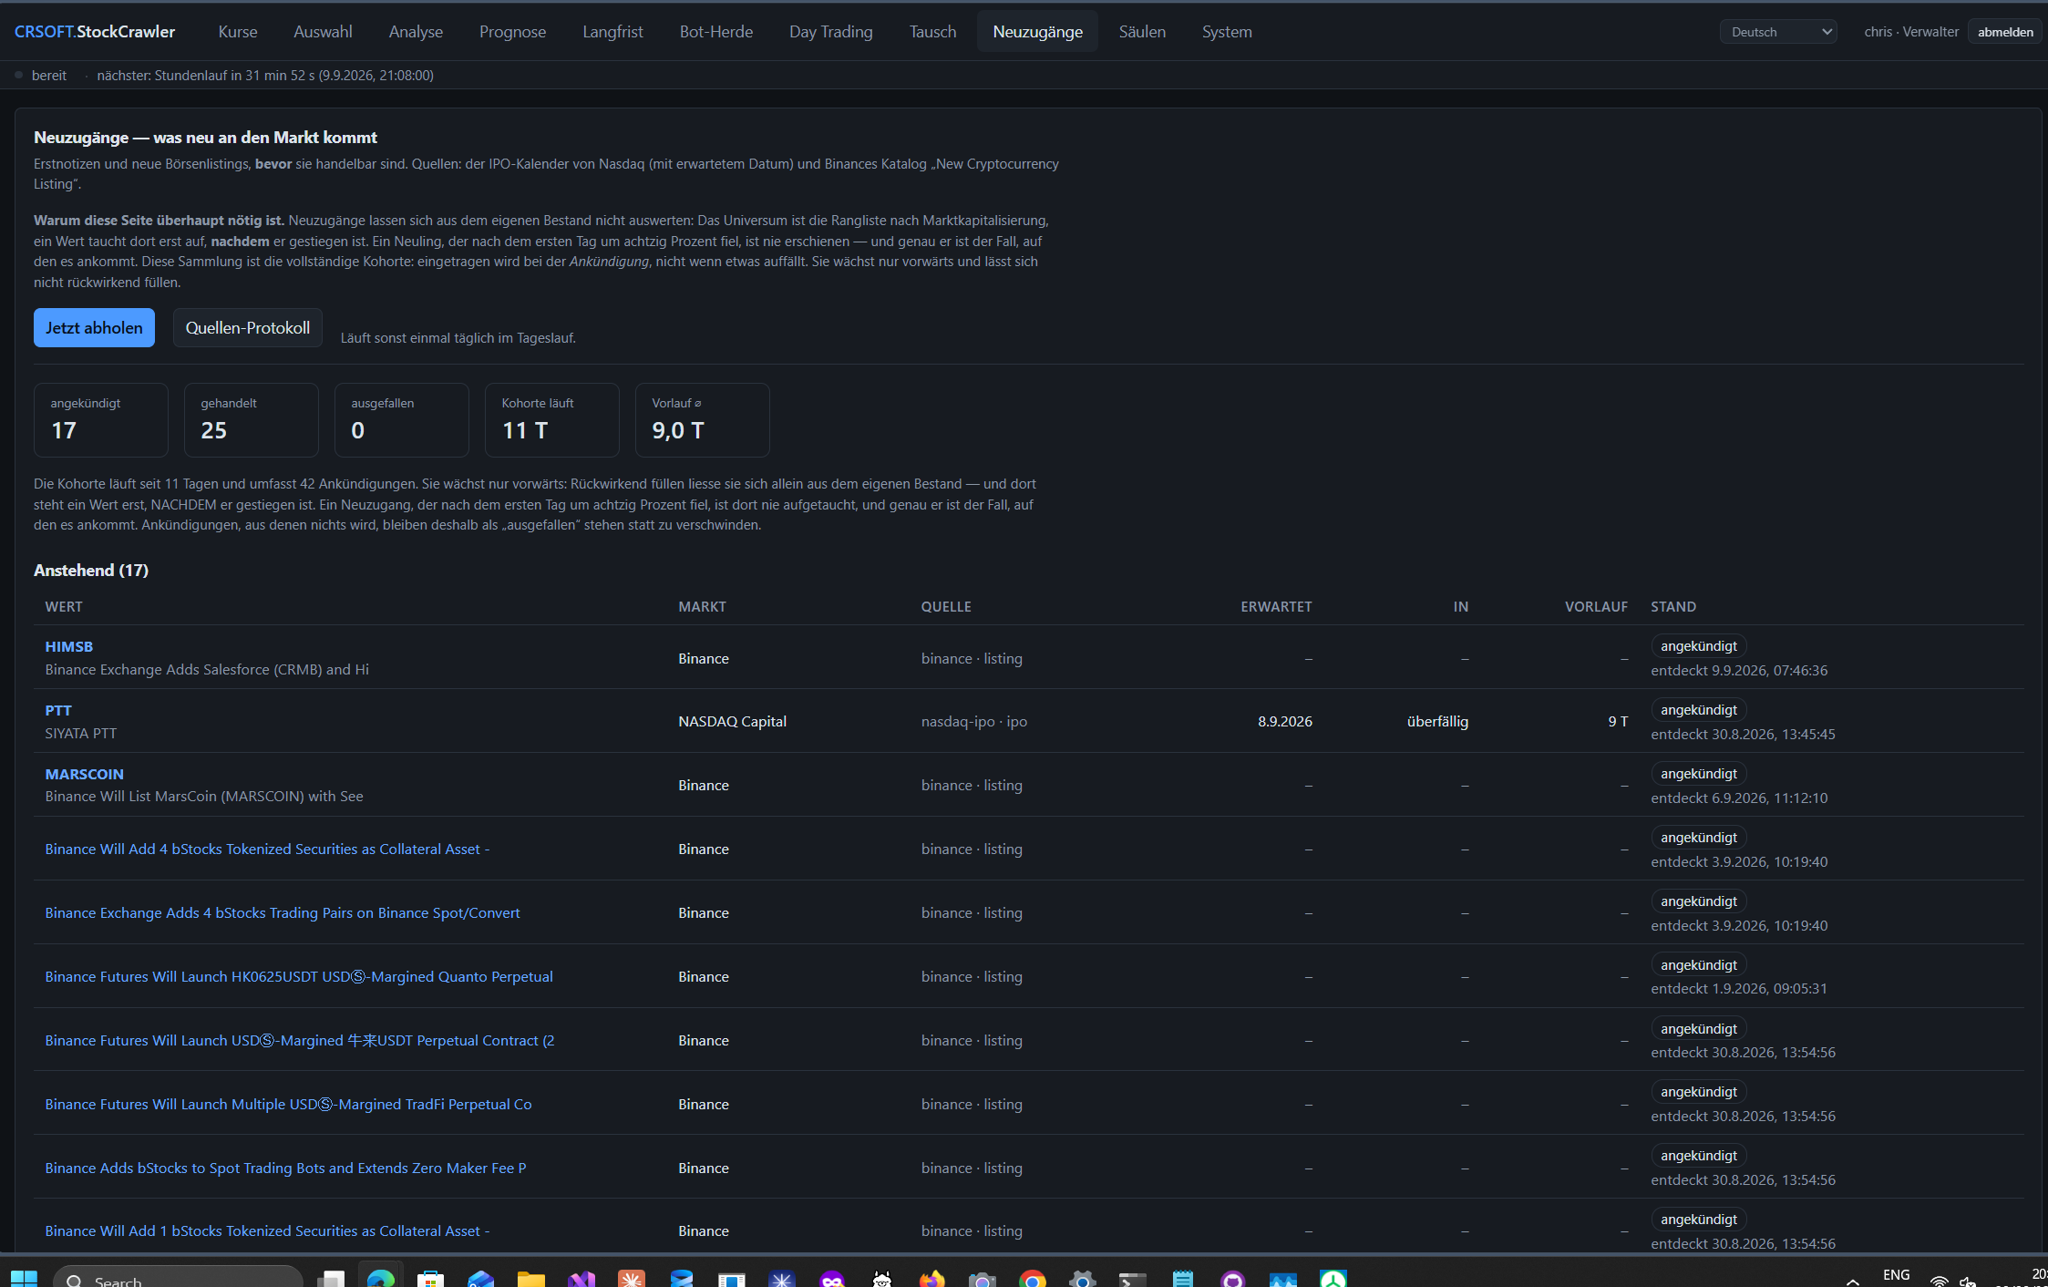
streng,aktiv,haltenundinvers. Die inverse Strategie hält die schwächstbewerteten Werte als Gegenkontrolle. Erstaktiv − inverszeigt den Informationsgehalt des Signals. - Neuzugänge: Vorankündigungen aus dem Nasdaq-IPO-Kalender und Binances Listing-Katalog – als vollständige Kohorte einschließlich der Fehlschläge
Lokal betrieben, offen erweiterbar
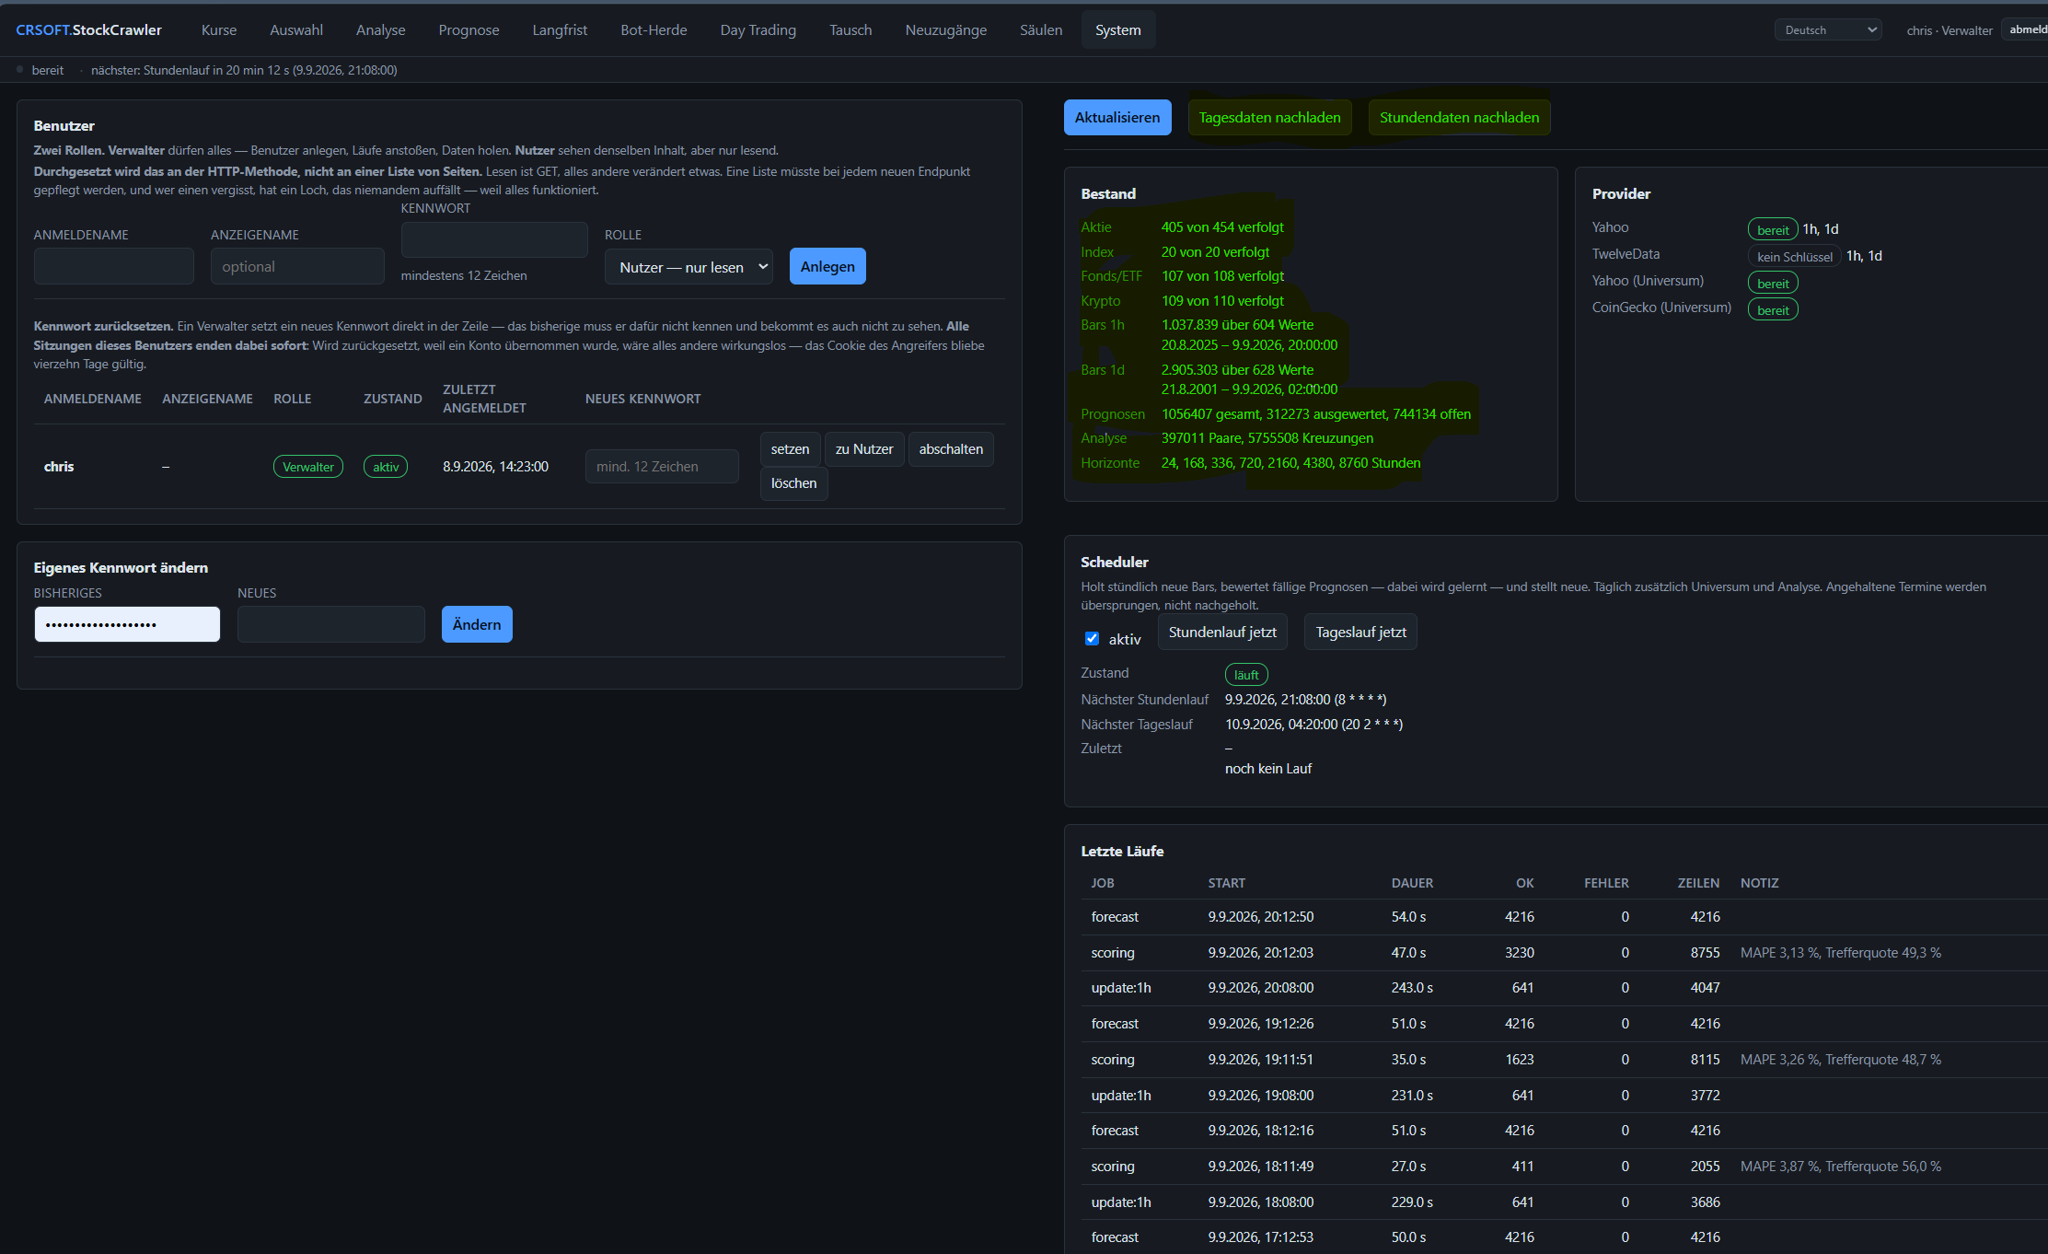
Der gesamte Ablauf läuft auf einem Rechner. Kurse, Prognosen und Bewertungen werden stündlich aktualisiert; Universum, Analyse, Neuzugänge und Autopilot täglich.
Die Oberfläche ist mit 2.272 Texten vollständig auf Deutsch und Englisch verfügbar. Eine weitere Sprache besteht technisch nur aus einer zusätzlichen XML-Datei.
Zwei Rollen werden nicht bloß über eine Liste von Seiten geschützt, sondern direkt an der HTTP-Methode. Damit gilt die Regel auch für Endpunkte, die heute noch gar nicht existieren.
Was als Nächstes geplant ist
Das Projekt ist offen, aber nicht fertig. Auf der Liste stehen unter anderem:
- mehr Testabdeckung für
Ingest.Core/Analysis, - das Auflösen eines Kopfstaus in der Bewertungswarteschlange,
- das Aussortieren von Werten ohne Kursdaten,
- Zugangsdaten in User Secrets statt in
appsettings.json, - soziale Kanäle als zusätzliche Quellen,
- die Anbindung von SEC EDGAR,
- Leerverkäufe im virtuellen Depot,
- gekoppelte Zahlen- und Datumsformate für weitere Sprachen.
Gerade die Mathematik ist bewusst abhängigkeitsfrei und gut testbar. Die Testabdeckung ist damit einer der dankbarsten Einstiegspunkte für neue Beitragende.
Was CRSOFT.StockCrawler nicht ist
Kein Handelssystem und keine Anlageberatung. Die Anwendung sagt an keiner Stelle, was gekauft werden soll. Sie beantwortet die Frage davor:
Was lässt sich überhaupt messen – und trägt es die Kosten?
Es gibt keine Prognose ohne ihre gemessene Güte. Jede Zahl, die die Anwendung anzeigt, hat eine Messung hinter sich. Diese Messung steht dort, wo jemand die Zahl sonst für bare Münze nehmen würde: direkt daneben.
Was ein Verfahren im Sperrbereich trägt und was nicht, entscheidet über sein Gewicht am Ergebnis. Eine Säule ohne Nachweis bewegt nichts – selbst dann nicht, wenn ihr Regler auf hundert steht.
Vielleicht ist genau das der größte Unterschied dieses Projekts: CRSOFT.StockCrawler versucht nicht, Gewissheit zu verkaufen. Es macht Unsicherheit sichtbar, prüft Behauptungen an unbekannten Daten und zeigt offen, wo Mathematik, Wissen und KI einen messbaren Beitrag leisten – und wo nicht.
Die vollständigen Messreihen – je Säule, je Horizont und
einschließlich der Verfahren, die nichts getragen haben – stehen in den
technischen Unterlagen unter CRS.StockCrawler/docs/ und in
der Anwendung selbst.
CRSOFT.StockCrawler ist ein offenes, lokal betriebenes Analyseprojekt. Es stellt keine Anlageberatung und keine Kauf- oder Verkaufsempfehlung dar.
Free & open-source repository https://github.com/chrisreiter/CRSOFT.StockCrawler.AI
CRSOFT.StockCrawler: When numbers, news, and expertise come together to analyze the market
What if a single system could mathematically analyze stocks, ETFs, cryptocurrencies, and indices from 17 stock exchanges—while simultaneously understanding stock market news from around the world as well as the relevant academic literature?
Language-independent. On a single computer. No cloud required. Open-source and free.
That’s exactly what CRSOFT.StockCrawler is.
The system combines price data, mathematical analyses, news, and technical literature in a single vector space. NVIDIA Nemotron brings this information together—and must verify every number used.
In numbers, that means:
641 values · 3.9 million price bars · 397,011 analyzed value pairs · 35 news sources · 42,219 sections of specialized literature · 978,837 forecasts.
This is the kind of system for which providers charge five-figure annual license fees.
But then comes the part that many of them don’t include: measuring what actually works. Everything is tested against a control group. And if a method doesn’t perform, that’s clearly stated in the interface—not in the fine print.
The entire chain in a single system
   Kurse          17 Börsen, live, stündlich, zurück bis 2001
      ↓
   Mathematik     Korrelationen · Kreuzungen · Vorlauf · Kurvendiskussion
      ↓           Spektralanalyse · Kapitalfluss · Zeitzonen
   Nachrichten    35 Quellen weltweit, in jeder Sprache
      ↓
   Vektorraum     sprachunabhängig – gemeinsam mit der Fachliteratur:
      ↓           arXiv, Dissertationen, Klassiker
   Reasoning      NVIDIA Nemotron, das jede Zahl belegen muss
      ↓
   Täglich        Journal · Auffälligkeiten · Trends · Prognosen
641 securities from 17 exchanges
The starting point is 405 stocks, 109 cryptocurrencies, 107 funds and ETFs, as well as 20 indices and currencies.
The data comes from sources including Xetra, as well as from Paris, London, Zurich, Tokyo, Amsterdam, Vienna, Milan, Madrid, Stockholm, Hong Kong, and the U.S. stock exchanges. In total, the database comprises 3,941,331 price bars at daily and hourly resolution—some dating back as far as the year 2001. New data is added hourly.
The fact that different stock exchanges have different trading calendars, sounds like a minor detail at first. In fact, it is one of the most common pitfalls: Anyone who performs calculations based on the raw time grid quickly ends up measuring the calendar rather than the market—and does so convincingly enough to believe it.
Three analyses in this project failed precisely because of this before the problem was resolved.
Mathematics Instead of Gut Feelings
The mathematical analysis begins with this data set:
- 397,011 pairs of values were analyzed for correlation, best timing, and direction.
- Crossings indicate when two normalized curves have swapped places—with a ranking based on pair gains and performance in separate time periods.
- The curve analysis searches the entire data set for high points, low points, inflection points, and saddle points. It is based on local polynomial fits as well as spikes in slope and curvature.
- Compare leading indicators and time zone leads for Tokyo, Europe, and New York—with a clear distinction between true leads and mere overlap.
- Spectral analysis examines period lengths, cycle stability, momentary cycles, and SSA.
- Capital flow distinguishes between redistribution and inflows/outflows, and identifies potential signs of rotation.
- The analysis of bot herds measures, across thousands of events, what publicly known triggers actually leave behind in the market.
The crucial question here is never simply: Is there a pattern? But rather: Does anything remain of it when tested against data that the method has not seen before?
35 news sources – in every language
In parallel with price movements, the system scans news hourly. Currently, there are 35 sources from eleven regions and 11,644 articles.
These include Reuters, WSJ, FT, CNBC, MarketWatch, Handelsblatt, NZZ, Der Standard, Nikkei, South China Morning Post, Economic Times, CoinDesk, and Cointelegraph. Also included are the Fed, ECB, Bank of England, BIS, and SEC, as well as UN News for global events.
The key feature is its language independence. The embedding model bge-m3 is multilingual: A German query will also find a Japanese news item without any translation taking place anywhere. There is no translation step because none is necessary—the vectors lie in the same space.
Social media channels are not currently included. The feed layer can, in principle, accommodate any RSS or Atom feed. The technical extension is therefore minor; the real work lies in measuring the signal quality.
When today’s news meets yesterday’s research
The specialized literature also lies in the same vector space: 55 sources with 42,219 sections, each with a source, page, and text anchor.
Included are:
- 41 arxiv papers on limit order books, statistical arbitrage, market making, execution strategies, and deep learning in trading,
- 12 public-domain classics, including Lefèvre, Selden, Harper, Clews, Crump, Gibson, Lawson, Rice, Brandenburg, Butler, and Francis,
- a dissertation on market microstructure and algorithmic trading,
- a BIS working paper on high-frequency trading.
News and literature are not stored in separate silos. A question about loss aversion finds its appropriate place in the textbook and, at the same time, in this morning’s news—without anyone having to manually create this connection.
NVIDIA Nemotron: An Explanator Instead of an Oracle
nemotron3:33b answers questions about forecasts, curve events, correlations, and accumulated knowledge. In doing so, it follows a strict rule: The model must not invent any numbers.
Every number comes from a tool call. The name, arguments, and result of this call are listed below each answer. Anyone who is skeptical of a statement can check it.
Nemotron responds in the language of the question. It is, in this context, explicitly an explainer, not an oracle: The model reads existing forecasts, classifies them, and explains relationships. It does not generate the forecasts itself. That is why the Reasoning pillar also has no weight in the result.
What’s generated every day
The system has now generated 978,837 live forecasts across seven time horizons—ranging from 24 hours to one year. 303,465 of these have already been evaluated against the price that later actually materialized.
This results in the following every day:
- a market journal that brings together what has moved, what was reported about it, and what the measurement shows regarding it, as well as
- a daily overview of notable points, weighted by their significance multiplied by the measured return of the respective pillar,
- trends, anomalies, and forecasts along with their visible quality.
The journal is deliberately written without a language model. Every number comes from a query; the accompanying sentence is a template and not freely generated text.
The reason for this is very specific: A smaller model once interpreted a error ratio of 1.0034 as “nearly perfect” and thereby claimed the opposite of the tool’s output. Anything that appears in a journal or a blog must remain verifiable.
The most important part: What actually holds up?
Every forecast is evaluated against the price that actually occurred—not in a retrospective analysis, but against prices that no model in this application has ever seen.
Hit rate, error ratio, and expected value after costs are displayed for each security and each time horizon directly in the interface— next to the forecast to which they refer.
That is also why CRSOFT.StockCrawler does not provide any buy recommendations. Anyone who sees the measured quality of a forecast right next to it doesn’t need a ready-made recommendation. They can make their own decision—based on a foundation that can be verified.
Eight pillars, but no weight without evidence
Each of the eight pillars poses a different question to the same data. Each can be activated and weighted. But none of them moves anything without measured support.
Weighting is determined by the control × merit. The merit comes from the restricted range—not from the setting.
| Pillar | Task |
|---|---|
| Course Learning | Five submodels whose weights are continuously adjusted based on their own errors. The only pillar that currently feeds into the stored forecasts. |
| Mathematical Analysis | Spectrum, cycle stability, instantaneous cycle, SSA, and Hurst – signal processing on individual time series. |
| Cash Flow | Redistribution versus inflows and outflows, suspicion of rotation, and groups with preserved sum. |
| Deep Learning | Three ONNX models across separate time bands, running on the CPU. |
| Knowledge | Embedded technical literature and measured bot patterns as a contribution. |
| Semantics | News sentiment, calibrated against the subsequent return. |
| Reasoning | Explains, but does not factor into calculations. |
| Curve Analysis | Peak, trough, inflection, and saddle points via local polynomial fitting. |
From Analysis to Virtual Portfolio
CRSOFT.StockCrawler doesn’t stop at correlations and forecasts. The application also examines how signals behave under more realistic conditions.
Analysis
- Correlations and leading indicators based on 397,011 evaluated pairs, including best lag and direction
- Crossovers of normalized curves with a ranking by pair profit and performance across separate time periods
- Curve analysis across the entire dataset, causally or centered smoothed, with linking of simultaneous events
- Global population and time zones with a clear separation of lead time and mere overlap
- Bot flocks: measurable traces of publicly known triggers such as moving averages, RSI, and Bollinger Bands
- Reverse reasoning: Is a signal perhaps valid if you flip it?
Forecast and Quality
- Seven horizons, exactly one deduplicated observation per value and target date Learning curve: Is the system actually improving?
- Learning curve: Is the system actually improving?
- Combined comparison: Does merging the columns actually bring any benefit?
- Retrospective as a cumulative lead over the status quo
Trading and Portfolio
- Day Trading: Not “What should I buy?”, but: Does the market even support intraday trading today, after fees have been deducted?
- Portfolio Rebalancing: Rebalancing suggestions based on your own portfolio
- Long-term: Returns, deepest declines, and baskets – with visible survival bias
- Virtual Portfolio: Settlement accounts in EUR and USD, fees per transaction, transaction journal, and asset performance
- Autopilot with four strategies:
streng,aktiv,haltenandinvers. The inverse strategy holds the lowest-valued stocks as a counterbalance. Firstaktiv − inversshows the information content of the signal. - New Listings: Advance announcements from the Nasdaq IPO calendar and Binance’s listing catalog—as a complete cohort, including failed listings
Operated locally, openly extensible
The entire process runs on a single computer. Prices, forecasts, and valuations are updated hourly; the universe, analysis, new additions, and autopilot are updated daily.
The interface is fully available in German and English with 2,272 text entries. Adding another language technically requires only an additional XML file.
Two roles are protected not merely by a list of pages, but directly at the HTTP method level. This means the rule also applies to endpoints that do not even exist yet.
What’s Planned Next
The project is open-ended but not yet complete. Items on the list include, among others:
- greater test coverage for
Ingest.Core/Analysis, - resolving a bottleneck in the rating queue,
- filtering out values without course data,
- storing access data in User Secrets instead of
appsettings.json, - social media channels as additional sources,
- integration with SEC EDGAR,
- short sales in the virtual portfolio,
- linked number and date formats for additional languages.
The mathematics, in particular, is deliberately free of dependencies and easy to test. Test coverage is therefore one of the most rewarding entry points for new contributors.
What CRSOFT.StockCrawler is not: No trading system and no investment advice. The
It is neither a trading system nor investment advice. The application never tells you what to buy. It answers the question that comes before that:
What can actually be measured—and does it justify the costs?
There is no forecast without its measured quality. Every number that the application displays is backed by a measurement. This measurement appears right where someone would otherwise take the number at face value: directly next to it.
What a process in the restricted area contributes—and what it does not—determines its weight in the result. A pillar without evidence moves nothing— not even if its dial is set to one hundred.
Perhaps that is precisely the biggest difference in this project: CRSOFT.StockCrawler does not attempt to sell certainty. It makes uncertainty visible, tests claims against unknown data, and openly shows where mathematics, knowledge, and AI make a measurable contribution— and where they do not.
The complete data sets—for each column, each time horizon, and including the methods that yielded no results—are available in the technical documentation under CRS.StockCrawler/docs/ and in the application itself.
CRSOFT.StockCrawler is an open, locally operated analysis project. It does not constitute investment advice or a recommendation to buy or sell.
repository gratuito e open source https://github.com/chrisreiter/CRSOFT.StockCrawler.AI
CRSOFT.StockCrawler: Quando numeri, notizie e competenze specialistiche si uniscono per interpretare il mercato
Cosa succederebbe se un unico sistema analizzasse matematicamente azioni, ETF, criptovalute e indici di 17 piazze finanziarie – e allo stesso tempo comprendesse le notizie di borsa provenienti da tutto il mondo e la letteratura specialistica in materia? Indipendente dalla lingua. Su un unico computer. Senza cloud. Aperto e
Indipendente dalla lingua. Su un singolo computer. Senza cloud. Aperto e gratuito.
CRSOFT.StockCrawler è proprio questo.
Il sistema combina dati sui prezzi, analisi matematiche, notizie e letteratura specialistica in un unico spazio vettoriale. NVIDIA Nemotron riunisce queste informazioni – e deve documentare ogni numero utilizzato .
In cifre ciò significa:
641 valori · 3,9 milioni di barre di quotazione · 397.011 coppie di valori analizzate · 35 fonti di notizie · 42.219 sezioni di letteratura specialistica · 978.837 previsioni.
Questa è la struttura per la quale i fornitori richiedono licenze annuali a cinque cifre.
Ma poi arriva la parte che molti di loro non forniscono: la misurazione di ciò che effettivamente funziona. Tutto viene verificato rispetto a un intervallo di esclusione. E se un metodo non produce risultati, questo viene indicato chiaramente nell’interfaccia – non nelle note a piè di pagina.
L’intera catena in un unico sistema
   Kurse          17 Börsen, live, stündlich, zurück bis 2001
      ↓
   Mathematik     Korrelationen · Kreuzungen · Vorlauf · Kurvendiskussion
      ↓           Spektralanalyse · Kapitalfluss · Zeitzonen
   Nachrichten    35 Quellen weltweit, in jeder Sprache
      ↓
   Vektorraum     sprachunabhängig – gemeinsam mit der Fachliteratur:
      ↓           arXiv, Dissertationen, Klassiker
   Reasoning      NVIDIA Nemotron, das jede Zahl belegen muss
      ↓
   Täglich        Journal · Auffälligkeiten · Trends · Prognosen
641 valori provenienti da 17 piazze di borsa
Il punto di partenza è costituito da 405 azioni, 109 criptovalute, 107 fondi e ETF, nonché 20 indici e valute.
I dati provengono, tra l’altro, da Xetra, nonché da Parigi, Londra, Zurigo, Tokyo, Amsterdam, Vienna, Milano, Madrid, Stoccolma, Hong Kong e dalle borse statunitensi. Complessivamente, il database comprende 3.941.331 bar di quotazione con risoluzione giornaliera e oraria – in parte risalenti fino al 2001. Ogni ora se ne aggiungono di nuovi.
Il fatto che le diverse borse abbiano calendari di negoziazione diversi, a prima vista sembra un dettaglio. In realtà è una delle insidie più comuni: chi effettua calcoli basandosi sulla griglia temporale grezza finisce presto per misurare il calendario anziché il mercato – e in modo abbastanza convincente da crederci.
Tre analisi di questo progetto sono fallite proprio per questo motivo, prima che il problema venisse risolto.
Matematica anziché intuito
Partendo da questa base di dati, ha inizio l’analisi matematica:
- 397.011 coppie di valori sono state analizzate in base alla correlazione, al miglior tempismo e alla direzione.
- Gli incroci mostrano quando due curve normalizzate hanno scambiato le posizioni – con una classifica in base al guadagno per coppia e alla performance in periodi di tempo distinti.
- L’analisi delle curve ricerca nell’intero portafoglio i punti massimi, minimi, di inversione e di sella. La base è costituita da adattamenti polinomiali locali, nonché da picchi di pendenza e curvatura.
- Confronto tra indicatori anticipatori e anticipo dei fusi orari: Tokyo, Europa e New York – con una chiara distinzione tra vero anticipo e semplice sovrapposizione.
- L’analisi spettrale esamina le lunghezze dei periodi, la stabilità dei cicli, i cicli momentanei e l’SSA.
- Il flusso di capitale distingue la ridistribuzione dagli afflussi e dai deflussi e rileva possibili sospetti di rotazione.
- L’analisi del branco di bot misura, su migliaia di eventi, quali effetti lasciano effettivamente sul mercato i fattori scatenanti di dominio pubblico.
La domanda cruciale non è mai solo: «Esiste uno schema?» ma piuttosto: «Ne rimane qualcosa se lo si verifica su dati che il metodo non ha mai visto prima?»
35 fonti di notizie – in ogni lingua
Parallelamente alle quotazioni, il sistema legge le notizie ogni ora. Attualmente sono 35 le fonti provenienti da undici regioni e 11.644 articoli.
Tra queste figurano Reuters, WSJ, FT, CNBC, MarketWatch, Handelsblatt, NZZ, Der Standard, Nikkei, South China Morning Post, Economic Times, CoinDesk e Cointelegraph. A queste si aggiungono la Fed, la BCE, la Banca d’Inghilterra, la BRI e la SEC, oltre a UN News per gli avvenimenti mondiali.
Il punto fondamentale è l’indipendenza dalla lingua. Il modello di incorporamento bge-m3 è multilingue: una domanda in tedesco trova anche una notizia in giapponese, senza che venga effettuata alcuna traduzione . Non c’è alcuna fase di traduzione, perché non è necessaria: i vettori si trovano nello stesso spazio.
I canali social non sono ancora inclusi. Il livello del feed può in linea di principio accogliere qualsiasi fonte RSS o Atom. L’estensione tecnica è quindi minima; il vero lavoro consiste nel misurare la qualità del segnale.
Quando la notizia di oggi incontra la ricerca di ieri
Nello stesso spazio vettoriale si trova anche la letteratura specialistica: 55 fonti con 42.219 paragrafi, ciascuno con fonte, pagina e ancora testuale.
Sono inclusi:
- 41 articoli arxiv su limit order book, arbitraggio statistico, market making, strategie di esecuzione e deep learning nel trading,
- 12 classici di dominio pubblico, tra cui Lefèvre, Selden, Harper, Clews, Crump, Gibson, Lawson, Rice, Brandenburg, Butler e Francis,
- una tesi di dottorato sulla microstruttura del mercato e sul trading algoritmico,
- un documento di lavoro della BRI sul trading ad alta frequenza.
Notizie e letteratura non sono confinate in silos separati. Una domanda sull’avversione alla perdita trova il punto giusto nel libro di testo e, allo stesso tempo, la notizia di questa mattina – senza che nessuno abbia creato manualmente questo collegamento.
NVIDIA Nemotron: un «spiegatore» anziché un «oracolo»
nemotron3:33b risponde a domande su previsioni, eventi relativi alle curve, collegamenti e conoscenze accumulate. A tal proposito vale una regola ferrea: il modello non deve inventare alcun numero.
Ogni numero proviene da una chiamata a uno strumento. Il nome, gli argomenti e il risultato di tale chiamata sono riportati sotto ogni risposta. Chi diffida di un’affermazione può verificare.
Nemotron risponde nella stessa lingua della domanda. È, quindi, esplicitamente uno spiegatore, non un oracolo: il modello legge le previsioni esistenti, le classifica e ne spiega le correlazioni. Non genera le previsioni autonomamente. Per questo motivo, il pilastro del ragionamento non ha nemmeno alcun peso sul risultato.
Cosa viene generato ogni giorno
Il sistema ha ormai generato 978.837 previsioni in tempo reale su sette orizzonti temporali – da 24 ore fino a un anno. Di queste, 303.465 sono già state valutate rispetto al corso che si è poi effettivamente verificato.
Da questi dati nasce ogni giorno:
- un diario di mercato che riassume ciò che si è mosso, ciò che è stato riportato al riguardo e ciò che emerge dalla misurazione,
- una panoramica giornaliera dei punti salienti, ponderata in base alla rilevanza moltiplicata per il rendimento misurato della rispettiva colonna,
- tendenze, anomalie e previsioni con la loro qualità visibile.
Il diario viene redatto volutamente senza un modello linguistico; ogni numero proviene da una query; la frase che lo circonda è un modello e non un testo generato liberamente.
Il motivo è molto concreto: un modello più piccolo ha interpretato una volta un rapporto di errore di 1,0034 come «quasi perfetto» e ha così affermato il contrario di quanto riportato dallo strumento. Ciò che viene pubblicato in un diario o in un blog deve rimanere verificabile.
La parte più importante: cosa funziona davvero?
Ogni previsione viene valutata rispetto al corso che si è effettivamente verificato. Non in un calcolo a ritroso, ma rispetto a corsi che nessun modello di questa applicazione ha mai visto.
Tasso di successo, rapporto di errore e valore atteso al netto dei costi sono visualizzati per ogni titolo e per ogni orizzonte temporale direttamente nell’interfaccia – accanto alla previsione a cui si riferiscono.
Questo è anche il motivo per cui CRSOFT.StockCrawler non fornisce alcuna raccomandazione di acquisto. Chi vede la qualità misurata di una previsione proprio accanto ad essa, non ha bisogno di una raccomandazione preconfezionata. Può prendere la propria decisione – su una base che può essere verificata.
Otto pilastri, ma nessun peso senza prove
Ciascuno degli otto pilastri pone una domanda diversa sugli stessi dati. Ciascuno può essere attivato e ponderato. Ma nessuno influisce senza un' base misurabile.
La ponderazione avviene tramite il regolatore × merito. Il merito proviene dall’intervallo di blocco – non dall’impostazione.
| Pilastro | Compito |
|---|---|
| Apprendimento del corso | Cinque modelli parziali, i cui pesi vengono costantemente aggiornati in base al proprio errore. L’unico pilastro che attualmente confluisce nelle previsioni salvate. |
| Analisi matematica | Spettro, stabilità del ciclo, ciclo istantaneo, SSA e Hurst – elaborazione del segnale sulla singola serie. |
| Flusso di capitale | Ridistribuzione rispetto ad afflussi e deflussi, sospetto di rotazione e gruppi con somma invariata. |
| Deep Learning | Tre modelli ONNX su bande temporali separate, elaborati sulla CPU. |
| Conoscenze | Letteratura specialistica integrata e modelli di bot rilevati come contributo. |
| Semantica | Tonalità delle notizie, calibrata in base al successivo rendimento. |
| Ragionamento | Spiega, ma non entra nel calcolo. |
| Analisi delle curve | Punti massimi, minimi, di inversione e di sella tramite adattamento polinomiale locale . |
Dall’analisi al portafoglio virtuale
CRSOFT.StockCrawler non si limita alle correlazioni e alle previsioni . L’applicazione esamina anche come i segnali si comportano in condizioni più realistiche.
Analisi
- Correlazioni e indicatori anticipatori su 397.011 coppie analizzate, compresi il miglior lag e la direzione
- Incroci di curve normalizzate con classifica in base al guadagno per coppia e alla performance in periodi separati
- Analisi delle curve sull’intero universo, livellate in modo causale o centrato, con collegamento di eventi simultanei
- Popolazione mondiale e fusi orari con netta separazione tra anticipazione e semplice sovrapposizione
- Branco di bot: tracce misurabili di trigger noti al pubblico come media mobile, RSI e Bollinger
- Ragionamento a ritroso: un segnale può forse essere valido se lo si inverte?
Previsione e qualità
- sette orizzonti, per ogni valore e data obiettivo esattamente un’osservazione depistata;
- Curva di apprendimento: il sistema migliora davvero?
- Confronto combinato: l’unione delle colonne porta davvero a qualcosa?
- Retrospettiva come vantaggio cumulativo rispetto all’immobilismo
Trading e portafoglio
- Day trading: non «Cosa dovrei comprare?», ma: Il mercato oggi consente effettivamente un’operazione intraday, al netto delle commissioni?
- Scambio: suggerimenti di ribilanciamento in base al proprio portafoglio
- Lungo termine: rendimenti, crolli più profondi e panieri – con evidente distorsione di sopravvivenza
- Portafoglio virtuale: conti di compensazione in EUR e USD, commissioni per operazione, giornale contabile e andamento del patrimonio
- Pilota automatico con quattro strategie:
streng,aktiv,halteneinvers. La strategia inversa mantiene i titoli con le valutazioni più basse come controllo incrociato. Innanzituttoaktiv − inversmostra il contenuto informativo del segnale. - Nuove quotazioni: anticipazioni dal calendario delle IPO del Nasdaq e dal catalogo delle quotazioni di Binance – come coorte completa, compresi i fallimenti
Gestito localmente, liberamente espandibile
L’intero processo si svolge su un unico computer. Quotazioni, previsioni e valutazioni vengono aggiornate ogni ora; universo, analisi, nuove aggiunte e pilota automatico quotidianamente.
L’interfaccia è completamente disponibile in tedesco e in inglese con 2.272 testi. L’aggiunta di un’altra lingua richiede tecnicamente solo un file XML aggiuntivo.
Due ruoli non sono protetti semplicemente tramite un elenco di pagine, ma direttamente a livello del metodo HTTP. Pertanto, la regola si applica anche agli endpoint che oggi non esistono ancora.
Cosa è in programma per il futuro
Il progetto è aperto, ma non è ancora completato. Tra le cose in programma ci sono, tra l’altro: una
- una maggiore copertura dei test per
Ingest.Core/Analysis, - la risoluzione di un ingorgo nella coda di valutazione,
- l’eliminazione dei valori privi di dati sui corsi,
- dati di accesso in User Secrets anziché nei
appsettings.json, - i canali social come fonti aggiuntive,
- l'integrazione con SEC EDGAR,
- vendite allo scoperto nel portafoglio virtuale,
- formati numerici e di data abbinati per altre lingue.
Proprio la matematica è volutamente indipendente da dipendenze e facilmente testabile. La copertura dei test è quindi uno dei punti di ingresso più accessibili per i nuovi collaboratori.
Cosa non è CRSOFT.StockCrawler :
Non è un sistema di trading né una consulenza d’investimento. L’ applicazione non indica in alcun punto cosa acquistare. Risponde invece alla domanda precedente:
Cosa si può effettivamente misurare – e ne vale la pena in termini di costi?
Non esiste una previsione senza la sua qualità misurata. Ogni numero che l’ applicazione mostra è supportato da una misurazione. Questa misurazione si trova proprio dove altrimenti qualcuno prenderebbe il numero per buono: direttamente accanto ad esso.
Ciò che una procedura nella zona di blocco sostiene e ciò che non sostiene determina il suo peso sul risultato. Un pilastro senza prove non muove nulla – nemmeno se il suo regolatore è impostato su cento.
Forse è proprio questa la differenza più grande di questo progetto: CRSOFT.StockCrawler non cerca di vendere certezze. Rende visibile l’incertezza, verifica le affermazioni basate su dati sconosciuti e mostra apertamente dove la matematica, la conoscenza e l’IA danno un contributo misurabile – e dove no.
Le serie di misurazioni complete – per ogni colonna, per ogni orizzonte e comprese le procedure che non hanno dato risultati – sono disponibili nella documentazione tecnica alla voce CRS.StockCrawler/docs/ e nell’applicazione stessa.
CRSOFT.StockCrawler è un progetto di analisi aperto e gestito a livello locale. Non costituisce una consulenza in materia di investimenti né una raccomandazione di acquisto o di vendita.
référentiel libre et open source https://github.com/chrisreiter/CRSOFT.StockCrawler.AI
CRSOFT.StockCrawler : Quand les chiffres, l’actualité et l’expertise s’allient pour analyser le marché
Et si un seul et même système analysait mathématiquement les actions, les ETF, les cryptomonnaies et les indices de 17 places boursières – tout en étant capable de comprendre l’actualité boursière du monde entier ainsi que la littérature spécialisée sur le sujet ? Indépendant de la langue. Sur un seul ordinateur. Sans cloud. Ouvert et
Indépendant de la langue. Sur un seul ordinateur. Sans cloud. Ouvert et gratuit.
C’est exactement ce qu’est CRSOFT.StockCrawler.
Le système combine les données de cours, les analyses mathématiques, les actualités et la littérature spécialisée dans un espace vectoriel commun. NVIDIA Nemotron rassemble ces informations – et doit justifier chaque chiffre utilisé.
En chiffres, cela signifie :
641 valeurs · 3,9 millions de barres de cours · 397 011 paires de valeurs analysées • 35 sources d’actualités • 42 219 extraits de littérature spécialisée • 978 837 prévisions. C’est la structure pour laquelle le fournisseur exige des licences annuelles à cinq chiffres.
C’est la structure pour laquelle les fournisseurs exigent des licences annuelles à cinq chiffres .
Mais vient ensuite la partie que beaucoup d’entre eux ne fournissent pas : la mesure de ce qui est réellement efficace. Tout est vérifié par rapport à une zone d’exclusion. Et si une méthode ne donne aucun résultat, cela est clairement indiqué dans l’interface – et non pas en petits caractères.
L'ensemble de la chaîne dans un seul système
   Kurse          17 Börsen, live, stündlich, zurück bis 2001
      ↓
   Mathematik     Korrelationen · Kreuzungen · Vorlauf · Kurvendiskussion
      ↓           Spektralanalyse · Kapitalfluss · Zeitzonen
   Nachrichten    35 Quellen weltweit, in jeder Sprache
      ↓
   Vektorraum     sprachunabhängig – gemeinsam mit der Fachliteratur:
      ↓           arXiv, Dissertationen, Klassiker
   Reasoning      NVIDIA Nemotron, das jede Zahl belegen muss
      ↓
   Täglich        Journal · Auffälligkeiten · Trends · Prognosen
641 valeurs issues de 17 places boursières
Le point de départ est constitué de 405 actions, 109 cryptomonnaies, 107 fonds et ETF, ainsi que 20 indices et devises.
Les données proviennent notamment de Xetra, ainsi que de Paris, Londres, Zurich, Tokyo, Amsterdam, Vienne, Milan, Madrid, Stockholm, Hong Kong et des places boursières américaines. Au total, le portefeuille comprend 3 941 331 barres de cours avec une résolution quotidienne et horaire – dont certaines remontent jusqu’en 2001. De nouvelles données s’ajoutent toutes les heures.
Le fait que différentes places boursières aient des calendriers de négociation différents, peut sembler à première vue un détail. En réalité, c’est l’un des pièges les plus courants : quiconque effectue des calculs sur la base d’une grille temporelle brute mesure rapidement le calendrier plutôt que le marché – et ce, de manière suffisamment convaincante pour y croire.
Trois analyses de ce projet ont échoué précisément pour cette raison avant que le problème ne soit résolu.
Les mathématiques plutôt que l'intuition
C’est sur cette base de données que commence l’analyse mathématique :
- 397 011 paires de valeurs ont été analysées pour déterminer leur corrélation, leur meilleur positionnement et leur direction.
- Les intersections indiquent quand deux courbes normalisées ont échangé leurs places – avec un classement par gain par paire et par performance sur des périodes distinctes.
- L’analyse des courbes recherche, sur l’ensemble du portefeuille, les points hauts, bas, de retournement et de selle. Elle s’appuie sur des ajustements polynomiaux locaux ainsi que sur les pics de pente et de courbure.
- Comparer les indicateurs avancés et l’avance des fuseaux horaires entre Tokyo, l’Europe et New York – avec une distinction claire entre l’avance réelle et le simple chevauchement.
- L’analyse spectrale examine les longueurs de période, la stabilité des cycles, les cycles instantanés et le SSA.
- Les flux de capitaux distinguent la redistribution des entrées et des sorties et identifient les soupçons éventuels de rotation.
- L’analyse des troupeaux de bots mesure, sur des milliers d’événements, ce que les déclencheurs connus du grand public laissent réellement sur le marché.
La question décisive n’est jamais simplement : « Y a-t-il un schéma ? » Mais : « En reste-t-il quelque chose lorsqu’on le vérifie sur des données que la méthode n’a pas vues auparavant ? »
35 sources d’information – dans toutes les langues
Parallèlement aux cours, le système analyse les actualités toutes les heures. Actuellement, il s’agit de 35 sources provenant de onze régions et de 11 644 articles.
Parmi celles-ci figurent Reuters, le WSJ, le FT, CNBC, MarketWatch, le Handelsblatt, la NZZ, Der Standard, Nikkei, South China Morning Post, Economic Times, CoinDesk et Cointelegraph. À cela s’ajoutent la Fed, la BCE, la Banque d’Angleterre, la BRI et la SEC, ainsi que les actualités de l’ONU pour les événements mondiaux.
Le point essentiel réside dans l’indépendance vis-à-vis de la langue. Le modèle d’intégration bge-m3 est multilingue : une question en allemand permet également de trouver une actualité en japonais, sans qu’aucune traduction ne soit effectuée. Il n’y a pas d’étape de traduction, car elle n’est pas nécessaire – les vecteurs se situent dans le même espace.
Les réseaux sociaux ne sont pour l’instant pas pris en compte. La couche de flux peut en principe intégrer n’importe quelle source RSS ou Atom. L’extension technique est donc minime ; le véritable travail consiste à mesurer la qualité du signal.
Lorsque l’actualité d’aujourd’hui croise la recherche d’hier
La littérature spécialisée se trouve également dans ce même espace vectoriel : 55 sources comportant 42 219 paragraphes, chacun avec sa source, sa page et son lien texte.
On y trouve :
- 41 articles arxiv sur les carnets d’ordres à cours limité, l’arbitrage statistique, l’impact sur le marché, les stratégies d’exécution et le deep learning dans le trading,
- 12 classiques du domaine public, dont Lefèvre, Selden, Harper, Clews, Crump, Gibson, Lawson, Rice, Brandenburg, Butler et Francis,
- une thèse sur la microstructure du marché et le trading algorithmique,
- un document de travail de la BRI sur le trading haute fréquence.
L’actualité et la littérature ne sont pas cloisonnées. Une question sur l’aversion à la perte trouve sa place dans le manuel et, en même temps, dans l’article de ce matin – sans que personne n’ait eu à établir manuellement ce lien.
NVIDIA Nemotron : un explicateur plutôt qu’un oracle
nemotron3:33b répond aux questions sur les prévisions, les événements liés aux courbes, les corrélations et les connaissances accumulées. Une règle stricte s’applique ici : le modèle ne doit inventer aucun chiffre. Chaque nombre provient d’un appel de fonction. Le nom, les arguments et le résultat de cet appel figurent sous chaque réponse. Quiconque se méfie d’une affirmation peut vérifier.
Chaque chiffre provient d’un appel de fonction. Le nom, les arguments et le résultat de cet appel figurent sous chaque réponse. Quiconque se méfie d’une affirmation peut vérifier.
Nemotron répond dans la langue de la question. Il s’agit ici expressément d’un explicateur, et non d’un oracle : le modèle lit les prévisions existantes, les classe et explique les liens entre elles. Il ne génère pas lui-même les prévisions. C’est pourquoi le pilier « Raisonnement » n’a pas non plus d’influence sur le résultat.
Ce qui se produit chaque jour
Le système a désormais généré 978 837 prévisions en temps réel sur sept horizons – de 24 heures à un an. 303 465 d’entre elles ont déjà été comparées au cours qui s’est ensuite effectivement réalisé.
Il en résulte chaque jour :
- un journal de marché qui rassemble ce qui a évolué, ce qui a été rapporté à ce sujet et ce que l’évaluation révèle à ce sujet, ainsi qu’
- un aperçu quotidien des points marquants, pondéré en fonction de leur importance et du rendement mesuré de la colonne correspondante,
- des tendances, des anomalies et des prévisions avec leur qualité visible.
Le journal est délibérément rédigé sans modèle linguistique. Chaque chiffre provient d’une requête ; la phrase qui l’accompagne est un modèle et non un texte généré librement.
La raison en est très concrète : un modèle de petite taille a un jour interprété un ratio d’erreurs de 1,0034 comme « quasi parfait » et a ainsi affirmé le contraire de la sortie de l’outil. Ce qui est publié dans un journal ou un blog doit rester vérifiable.
Le plus important : qu’est-ce qui est vraiment pertinent ?
Chaque prévision est évaluée par rapport au cours qui s’est effectivement réalisé. Non pas dans le cadre d’un calcul a posteriori, mais par rapport à des cours que aucun modèle de cette application n’a jamais observés.
Le taux de réussite, le taux d’erreur et la valeur attendue après coûts sont affichés pour chaque valeur et chaque horizon directement dans l’interface – à côté de la prévision à laquelle ils se rapportent.
C’est également la raison pour laquelle CRSOFT.StockCrawler ne donne aucune recommandation d’achat. Quiconque voit la qualité mesurée d’une prévision affichée directement à côté n’a pas besoin d’une recommandation toute faite. Il peut prendre sa propre décision – sur une base qui peut être vérifiée par calcul.
Huit piliers, mais pas de pondération sans justification
Chacun des huit piliers pose une question différente à partir des mêmes données. Chacun peut être activé et pondéré. Mais aucun ne fait bouger les choses sans un soutien mesuré.
La pondération s’effectue à l’aide du régulateur × mérite. Le mérite provient de la zone de blocage – et non du réglage.
| Pilier | Tâche |
|---|---|
| Apprentissage du cours | Cinq sous-modèles dont les pondérations sont continuellement ajustées en fonction de leurs propres erreurs. Le seul pilier qui alimente actuellement les prévisions enregistrées. |
| Analyse mathématique | Spectre, stabilité des cycles, cycle instantané, SSA et indice de Hurst – traitement du signal sur chaque série. |
| Flux de capitaux | Redistribution par rapport aux entrées et sorties, suspicion de rotation et groupes dont la somme reste inchangée. |
| Apprentissage profond | Trois modèles ONNX sur des bandes d'horizon distinctes, traités sur le processeur. |
| Connaissances | Documentation spécialisée intégrée et modèles de bots mesurés comme contribution. |
| Sémantique | Sentiment des actualités, calibré par rapport au rendement obtenu par la suite; . |
| Raisonnement | Explique, mais n’entre pas en ligne de compte dans les calculs. |
| Analyse des courbes | Points de maximum, de minimum, de retournement et de selle via un ajustement polynomial local. |
De l’analyse au portefeuille virtuel
CRSOFT.StockCrawler ne se limite pas aux corrélations et aux prévisions. L'application examine également comment les signaux se comportent dans des conditions plus réalistes.
Analyse
- Corrélations et indicateurs avancés sur 397 011 paires analysées, y compris le meilleur décalage et la meilleure direction
- Intersections de courbes normalisées avec classement par gain par paire et performance sur des périodes distinctes
- Analyse des courbes sur l’ensemble du portefeuille, lissées de manière causale ou centrée, avec mise en relation des événements simultanés
- Portefeuille mondial et fuseaux horaires avec séparation claire entre l'avance et le simple chevauchement
- Troupeau de bots : traces mesurables de déclencheurs connus du grand public tels que les moyennes mobiles, le RSI et les bandes de Bollinger
- Raisonnement a contrario : un signal est-il peut-être valable lorsqu’on le inverse ?
Prévision et qualité
- sept horizons, exactement une observation dédupliquée par valeur et par date cible
- Courbe d’apprentissage : le système s’améliore-t-il réellement ?
- Comparaison mixte : la fusion des colonnes apporte-t-elle réellement quelque chose ?
- Rétrospective sous forme d’avance cumulée par rapport à l’inaction
Trading et portefeuille
- Day trading : pas « Que dois-je acheter ? », mais : Le marché permet-il aujourd’hui de réaliser une transaction intrajournalière, une fois les frais déduits ?
- Échange : suggestions de rééquilibrage par rapport à votre propre portefeuille
- Long terme : rendements, creux les plus bas et paniers – avec un biais de survie visible
- Portefeuille virtuel : comptes de règlement en EUR et USD, frais par opération, journal comptable et évolution du patrimoine
- Pilote automatique avec quatre stratégies :
streng,aktiv,haltenetinvers. La stratégie inverse conserve les titres les moins bien notés à titre de contre-vérification. Tout d’abordaktiv − inversmontre la valeur informative du signal. - Nouvelles entrées : annonces préalables issues du calendrier des introductions en bourse du Nasdaq et du catalogue des cotations de Binance – sous forme de cohorte complète, y compris les échecs
Exploité localement, ouvertement extensible
L'ensemble du processus s'exécute sur un seul ordinateur. Les cours, les prévisions et les évaluations sont mis à jour toutes les heures ; l'univers, l'analyse, les nouvelles entrées et le pilote automatique sont mis à jour quotidiennement.
L’interface est entièrement disponible en allemand et en anglais avec 2 272 textes. L’ajout d’une autre langue ne nécessite techniquement qu’un fichier XML supplémentaire.
Deux rôles ne sont pas simplement protégés par une liste de pages, mais directement au niveau de la méthode HTTP. Ainsi, la règle s’applique également aux points de terminaison qui n’existent pas encore aujourd’hui.
Prochaines étapes
Le projet est ouvert, mais pas terminé. La liste comprend notamment :
- une couverture de test plus étendue pour
Ingest.Core/Analysis, - la résolution d’un engorgement dans la file d’attente d’évaluation,
- le filtrage des valeurs ne contenant pas de données de cours,
- le stockage des identifiants de connexion dans les « User Secrets » plutôt que dans
appsettings.json, - les réseaux sociaux comme sources supplémentaires,
- l’intégration de SEC EDGAR,
- les ventes à découvert dans le portefeuille virtuel,
- les formats de nombres et de dates adaptés à d’autres langues.
Les mathématiques, en particulier, sont délibérément indépendantes de toute dépendance et faciles à tester. La couverture des tests constitue ainsi l’un des points d’entrée les plus accessibles pour les nouveaux contributeurs.
Ce que CRSOFT.StockCrawler n’est pas :
Ce n’est ni un système de trading, ni un service de conseil en investissement. L’ application n’indique à aucun moment ce qu’il faut acheter. Elle répond à la question préalable :
Que peut-on réellement mesurer – et cela justifie-t-il les coûts ?
Il n’y a pas de prévision sans mesure de sa qualité. Chaque chiffre affiché par l’ application repose sur une mesure. Cette mesure se trouve là où l’on prendrait autrement le chiffre pour argent comptant : juste à côté.
Ce qu’une procédure dans la zone d’exclusion justifie et ce qu’elle ne justifie pas détermine son poids dans le résultat. Un pilier sans justification ne fait rien bouger – même si son régulateur est réglé sur cent.
C’est peut-être précisément là que réside la plus grande différence de ce projet : CRSOFT.StockCrawler ne cherche pas à vendre des certitudes. Il rend l’incertitude visible, vérifie les affirmations à partir de données inconnues et montre ouvertement où les mathématiques, les connaissances et l’IA apportent une contribution mesurable – et où ce n’est pas le cas.
Les séries de mesures complètes — par colonne, par horizon et y compris les méthodes qui n’ont donné aucun résultat — sont disponibles dans la doku technique sous CRS.StockCrawler/docs/ et dans l’application elle-même.
CRSOFT.StockCrawler est un projet d’analyse ouvert, exploité localement. Il ne constitue en aucun cas un conseil en investissement ni une recommandation d’achat ou de vente.
無料・オープンソースのリポジトリ https://github.com/chrisreiter/CRSOFT.StockCrawler.AI
CRSOFT.StockCrawler: 数字、ニュース、専門知識が一体となって市場を読み解く
もし、たった1つのシステムが、17の取引所の株式、ETF、仮想通貨、そして 指数を数学的に分析し、同時に 世界中の証券ニュースや関連する専門文献を 理解できるとしたらどうでしょうか?
言語に依存せず。1台のコンピュータ上で。クラウド不要。オープンで、無料。
まさにそれがCRSOFT.StockCrawlerです。
このシステムは、株価データ、数学的分析、ニュース、 専門文献を単一のベクトル空間に統合します。NVIDIA Nemotronが これらの情報を統合し、使用されるすべての数値について 根拠を示す必要があります。
数値で言えば、以下の通りです:
641の指標・390万本の価格バー・397,011組の分析済み 値ペア・35のニュースソース・42,219の専門文献セクション・ 978,837件の予測。
これこそが、プロバイダーが5桁の年間ライセンス料を 請求する根拠となっている構造です。
しかし、多くのプロバイダーが提供していない部分があります。それは、 どれが実際に成果を上げているかを測定することです。すべてが、 「非有効領域」と照らし合わせて検証されます。そして、ある手法が成果を上げない場合、 そのことはインターフェース上で明確に表示されます――細かい文字で書かれた利用規約の中ではありません。
一連のプロセス全体を1つのシステムに統合
   Kurse          17 Börsen, live, stündlich, zurück bis 2001
      ↓
   Mathematik     Korrelationen · Kreuzungen · Vorlauf · Kurvendiskussion
      ↓           Spektralanalyse · Kapitalfluss · Zeitzonen
   Nachrichten    35 Quellen weltweit, in jeder Sprache
      ↓
   Vektorraum     sprachunabhängig – gemeinsam mit der Fachliteratur:
      ↓           arXiv, Dissertationen, Klassiker
   Reasoning      NVIDIA Nemotron, das jede Zahl belegen muss
      ↓
   Täglich        Journal · Auffälligkeiten · Trends · Prognosen
17の取引所からの641の銘柄
出発点は、405銘柄の株式、109種類の仮想通貨、107の ファンドおよびETF、さらに20の指数と外国為替です。
データは、Xetraをはじめ、パリ、ロンドン、 チューリッヒ、東京、アムステルダム、ウィーン、ミラノ、マドリード、ストックホルム、香港、そして 米国の証券取引所などから取得されています。 ポートフォリオ全体では、日次および時間単位の解像度で3,941,331件の 価格バーを網羅しており、一部は 2001年まで遡ります。新しいデータは1時間ごとに追加されています。
各証券取引所によって取引カレンダーが異なることは、 一見すると些細なことに思えるかもしれません。しかし実際には、これは最もよくある 落とし穴の一つです。生の時間軸に基づいて計算を行うと、市場ではなくカレンダーを測定してしまい、 しかも、それを真実だと信じ込んでしまうほど説得力を持ってしまいます。
このプロジェクトにおける3つの分析は、まさにこの点で失敗に終わりました。その後、 この問題は解決されました。
直感ではなく数学
このデータに基づいて、数学的な分析が始まります:
- 397,011組の値ペアについて、相関関係、最適なタイミング、および方向性が分析された。
- 交点は2つの正規化された曲線が順位を入れ替わった時点を示しており、ペアごとの利益と各期間における実績に基づくランキングが示される。
- 曲線の分析では、データ全体を網羅して、高値点、安値点、転換点、鞍点を検索します。その基礎となるのは、局所的な多項式近似および傾きと曲率の急変です。
- 先行指標とタイムゾーンごとの先行度を比較します。 東京、ヨーロッパ、ニューヨーク――真の先行度と 単なる重なりを明確に区別して表示します。
- スペクトル分析では、周期の長さ、 サイクルの安定性、瞬間サイクル、およびSSAを調査します。
- 資金フローは、再分配と流入・流出を区別し、 回転取引の疑いがあるものを特定します。
- ボット群の分析は、数千件に及ぶイベントを通じて、 公に知られているトリガーが実際に市場にどのような影響を 残しているかを測定する。
その際の決定的な問いは、決して「パターンがあるか?」というだけではありません。 むしろ、「その手法がこれまで見たことのないデータで検証した際、そのパターンの痕跡は残るのか?」というものです。
35のニュースソース – あらゆる言語で
株価の推移と並行して、システムは1時間ごとにニュースを収集します。 現在、11の地域から35のソース、そして 11,644件の記事が対象となっています。
その中には、ロイター、WSJ、FT、CNBC、MarketWatch、Handelsblatt、NZZ、 Der Standard、日経、サウスチャイナ・モーニング・ポスト、エコノミック・タイムズ、CoinDesk、 Cointelegraphなどが含まれます。さらに、FRB、ECB、イングランド銀行、BIS、SEC、 そして世界的な出来事に関する国連ニュースも加わります。
重要なポイントは、言語に依存しないことです。この 埋め込みモデル bge-m3 は多言語対応です。ドイツ語の クエリでも、どこかで翻訳されることなく、日本語のニュース記事が見つかります。翻訳のステップは存在しません。必要がないからです――それらの ベクトルは同じ空間に存在しています。
ソーシャルメディアは現時点ではまだ含まれていません。フィード層は、原則としてあらゆるRSSやAtomソースを取り込むことができます。技術的な拡張は最小限で済みますが、実際の作業は、シグナルの品質を測定することにあります。
もし、 今日のニュースが昨日の研究と結びついたとしたら
専門文献も同様のベクトル空間に位置しています:55のソースが、 42,219のセクションを含み、それぞれにソース、ページ、および テキストアンカーが記録されています。
これには以下が含まれます:
- リミット・オーダーブック、 統計的アービトラージ、マーケット・インパクト、執行戦略、および取引におけるディープ ラーニングに関する41件のarxiv論文、
- パブリックドメインの古典12冊(レフェーヴル、セルデン、 ハーパー、クルース、クランプ、ギブソン、ローソン、ライス、ブランデンブルク、バトラー、そして フランシスを含む)、
- 市場のミクロ構造およびアルゴリズム取引に関する博士論文1編、
- 高頻度取引に関するBIS(国際決済銀行)のワーキングペーパー。
ニュースと文献は、別々のサイロに隔離されているわけではない。例えば、 「損失回避」に関する質問は、教科書内の適切な箇所と、 同時に今朝のニュース記事とを結びつける――誰かが手作業でこの 関連付けを行ったわけでもないのに。
NVIDIA Nemotron:オラクルではなく、説明者
nemotron3:33b は、予測、 曲線上のイベント、関連性、そして蓄積された知識に関する質問に答えます。その際、 厳格なルールが適用されます。モデルは数字を でっち上げてはならないのです。
すべての数値はツール呼び出しから得られます。その呼び出しの名称、引数、および結果は、各回答の下に表示されます。ある記述を疑う場合は、確認することができます。
Nemotronは質問と同じ言語で回答します。 それは、 明確に「解説者」であり、「オラクル」ではありません。このモデルは、 既存の予測を読み取り、それらを分類し、関連性を説明します。このモデルは、 予測自体を生成するわけではありません。そのため、推論の柱は、結果において、 何の重みも持ちません。
毎日生成されるもの
このシステムはこれまでに、24時間から1年までの7つの期間にわたって、978,837件のリアルタイム予測を 生成してきました。 そのうち303,465件は、後に実際に発生した価格と照らし合わせて、すでに評価が完了しています。 そこから毎日生成されるのは:
そこから毎日生成されるのは:
- 「市場ジャーナル」が作成されます。これには、何が動いたか、それについてどのような報道があったか、そしてそれに対する測定結果がまとめられ、 さらに、
- 注目すべき箇所の日次概要(注目度と各 柱の測定された収益を乗じた重み付けが施されています)、
- トレンド、特筆すべき点、および予測と、その 可視化された品質。
このジャーナルは、意図的に言語モデルを一切使用せずに作成されています。各数値はクエリから得られたものであり、それを囲む文章はテンプレートであり、自由に生成されたテキストではありません。
その理由は極めて具体的です。以前、小規模なモデルが、 エラー比率1.0034を「ほぼ完璧」と解釈し、 ツールの出力結果とは正反対の主張をしてしまったことがありました。ジャーナルや ブログに掲載される内容は、再計算が可能でなければなりません。
最も重要な点は、 そのうちのどれが実際に有効かということです。
あらゆる予測は、実際に発生した価格に対して評価されます。 事後検証ではなく、このアプリケーションのどのモデルもこれまで見たことのない価格に対して評価されるのです。
的中率、誤差率、およびコストを考慮した期待値は、各銘柄および各期間ごとに、インターフェース上に直接表示されます――それらが関連する予測のすぐ横に。
これが、CRSOFT.StockCrawlerが 買い推奨を行わない理由でもあります。予測の測定された精度を そのすぐ横で確認できるユーザーには、既成の推奨は必要ありません。ユーザーは、 検証可能な根拠に基づいて、独自の 判断を下すことができます。
8つの柱、しかし 裏付けのない重み付けはなし
8つの柱はそれぞれ、同じデータに対して異なる問いを投げかけます。 それぞれを有効化したり、重み付けしたりすることができます。しかし、測定された裏付けがなければ、 どれ一つとして動き出すことはありません。
重み付けは「調整係数 × 実績」で行われます。この実績は、 設定値ではなく、制限範囲から導き出されます。
| 柱 | 課題 |
|---|---|
| コース学習 | 5つの部分モデルで構成され、その重みは自身の誤差から継続的に調整されます。現在、保存された予測に反映される唯一の柱です。 |
| 数学的解析 | スペクトル、サイクル安定性、瞬間サイクル、SSA、ハースト – 個々の時系列に対する信号処理。 |
| キャッシュフロー | 流入・流出に対する再配分、回転の疑い、および合計が保持されたグループ。 |
| ディープラーニング | 別々の期間帯を対象とした3つのONNXモデル、処理は CPU上で実行。 |
| 知見 | 組み込まれた専門文献と測定されたボットのパターンを、 インプットとして活用。 |
| セマンティクス | ニュースのセンチメントを、その後発生したリターンに対してキャリブレーション。 |
| 推論 | 説明は行うが、計算には含まれない。 |
| 曲線の考察 | 局所的な多項式近似による高値点、安値点、転換点、およびサドル点。 分析から |
分析から仮想ポートフォリオまで
CRSOFT.StockCrawlerは、相関関係や予測に止まることはありません。 このアプリケーションは、より現実的な条件下でシグナルがどのように振る舞うかについても検証します。 分析から
分析
- 397,011組のペアを分析した相関関係と先行指標、 最適なタイミングと方向性を含む
- 正規化された曲線の交差、ペアごとの利益と、別々の期間における実績に基づくランキング、 およびポートフォリオ全体の曲線分析(因果関係または中心化平滑化)、
- 全銘柄を対象とした曲線の考察(因果関係または中心化による平滑化)、 同時発生イベントとの関連付け
- 世界全体のデータとタイムゾーンについて、先行期間と 単なる重複を明確に区別
- ボット群:移動平均、RSI、ボリンジャーバンドなど、公に知られているトリガーの測定可能な痕跡 逆説:シグナルを逆転させると、もしかすると有効になるのではないか?
- 逆説:シグナルを逆転させれば、もしかすると有効になるかもしれないか?
予測と精度
- 7つの時間軸、各銘柄および目標日ごとに、重複を排除した 観測値を1つずつ
- 学習曲線:システムは実際に改善されているか?
- 混合比較:各柱を統合することに、そもそも何らかの意味があるのだろうか?
- 振り返り:停滞状態に対する累積的なリードとして
取引とポートフォリオ
- デイトレード:「何を買えばいいか?」ではなく、: 手数料を差し引いた後、今日の市場は日中の取引を成り立たせるだけの価値が、 そもそもあるのか?
- ポートフォリオの入れ替え:自身の保有銘柄に基づいた リバランス提案
- 長期投資:リターン、最大下落幅、ポートフォリオ – 生存バイアスが明確に表れている
- 仮想ポートフォリオ:ユーロおよび 米ドル建ての決済口座、取引ごとの手数料、仕訳帳、資産推移
- 4つの戦略を備えたオートパイロット:
streng,aktiv,haltenおよびinvers。この逆戦略は、対照として最も評価の低い銘柄を保有し続けます。 まずaktiv − inversは、シグナルの情報量を示しています。 - 新規上場: ナスダックIPOカレンダーおよびバイナンス上場カタログからの事前告知 – 失敗例を含む完全な コホートとして
ローカルで稼働、自由に拡張可能
全プロセスは1台のコンピュータ上で実行されます。株価、予測、および 評価は1時間ごとに更新され、対象銘柄、分析、 新規追加、オートパイロットは毎日更新されます。
インターフェースは2,272件のテキストで、完全にドイツ語と英語で利用可能です。他の言語の追加は、技術的には追加のXMLファイル1つで済みます。
2つのロールは、単にページの一覧によって保護されるだけでなく、HTTPメソッドレベルで直接保護されています。これにより、このルールは、現在まだ存在しないエンドポイントにも適用されます。
今後の計画
このプロジェクトは進行中ですが、まだ完成していません。今後の予定には、 とりわけ以下の項目が含まれています:
- 評価キューのボトルネック解消に向けた
Ingest.Core/Analysis, - 評価キューにおけるボトルネックの解消、
- 価格データのない値の除外、
- ソーシャルチャネルではなく
appsettings.json, - ソーシャルチャネルを
- SEC EDGARとの連携、
- 仮想ポートフォリオでの空売り、
- その他の言語に対応した数値および日付形式の連携。
特に数学的な部分は、意図的に依存関係を持たず、テストしやすいよう設計されています。 そのため、テストカバレッジは、 新規貢献者にとって最も取り組みやすい入り口の一つとなっています。
CRSOFT.StockCrawlerがではないもの: 取引システムでも、投資アドバイスでもありません。このアプリは、
取引システムでも、投資アドバイスでもありません。このアプリケーションは、どこにおいても「何を買うべきか」を指示することはありません。むしろ、その前の質問、すなわち:
そもそも何が測定可能か――そして、それは コストに見合うのか?
測定された品質なしに予測は成り立ちません。このアプリケーションが示すあらゆる数値には、 その背後にある測定結果があります。この測定結果は、 通常ならその数値を鵜呑みにしてしまうであろう場所、つまりその数値のすぐ 隣に表示されています。
制限領域において、どの手法が有効で、どれがそうでないかが、その手法が結果に与える影響の大きさを決定します。 実証のない柱は、何ものをも動かすことはできません―― たとえその調整ダイヤルが100に設定されていたとしても。
おそらく、それこそがこのプロジェクトの最大の違いなのです: CRSOFT.StockCrawlerは、確実性を売り込もうとはしません。このツールは、 不確実性を可視化し、未知のデータに基づく主張を検証し、 数学、知識、AIが測定可能な貢献を果たしている場所―― そしてそうでない場所を、率直に示します。
完全な測定データ(各柱、各期間ごと、そして何の根拠も得られなかった手法も含む)は、技術文書内の CRS.StockCrawler/docs/ および、アプリケーション自体に公開されています。
CRSOFT.StockCrawlerは、オープンでローカルに運用される分析プロジェクトです。これは投資助言や、売買の推奨を構成するものではありません。
безкоштовний репозиторій з відкритим кодом https://github.com/chrisreiter/CRSOFT.StockCrawler.AI
CRSOFT.StockCrawler: Коли цифри, новини та фахові знання разом аналізують ринок
А що, якби єдина система математично аналізувала акції, ETF, криптовалюти та індекси 17 бірж — і водночас розуміла біржові новини з усього світу та відповідну фахову літературу?
Незалежно від мови. На одному комп’ютері. Без хмари. Відкрито та безкоштовно.
Саме це і є CRSOFT.StockCrawler.
Система об’єднує дані про курси, математичні аналізи, новини та фахову літературу в єдиному векторному просторі. NVIDIA Nemotron об’єднує цю інформацію — і має підтверджувати кожне використане число.
У цифрах це означає:
641 значення · 3,9 мільйона цінових барів · 397 011 проаналізованих пар значень · 35 джерел новин · 42 219 розділів фахової літератури · 978 837 прогнозів.
Саме за таку структуру постачальники вимагають п’ятизначні суми за річні ліцензії.
Але далі йде те, чого багато хто з них не надає: оцінка того, що з цього насправді працює. Усе перевіряється на відповідність контрольному діапазону. І якщо якийсь алгоритм не дає результатів, це відкрито вказується в інтерфейсі — а не дрібним шрифтом.
Весь ланцюжок в одній системі
   Kurse          17 Börsen, live, stündlich, zurück bis 2001
      ↓
   Mathematik     Korrelationen · Kreuzungen · Vorlauf · Kurvendiskussion
      ↓           Spektralanalyse · Kapitalfluss · Zeitzonen
   Nachrichten    35 Quellen weltweit, in jeder Sprache
      ↓
   Vektorraum     sprachunabhängig – gemeinsam mit der Fachliteratur:
      ↓           arXiv, Dissertationen, Klassiker
   Reasoning      NVIDIA Nemotron, das jede Zahl belegen muss
      ↓
   Täglich        Journal · Auffälligkeiten · Trends · Prognosen
641 цінних паперів із 17 біржових майданчиків
Відправною точкою є 405 акцій, 109 криптовалют, 107 фондів та ETF, а також 20 індексів і валют.
Дані надходять, зокрема, від Xetra, а також із Парижа, Лондона, Цюріха, Токіо, Амстердама, Відня, Мілана, Мадрида, Стокгольма, Гонконгу та з бірж США. Загалом база даних налічує 3 941 331 цінових барів із щоденною та погодинною деталізацією — частково аж до 2001 року. Щогодини додаються нові.
Те, що різні біржі мають різні торгові календарі, спочатку здається дрібницею. Насправді це одна з найпоширеніших пасток: той, хто проводить розрахунки на основі необробленої часової сітки, швидко вимірює календар, а не ринок — і робить це настільки переконливо, що в це можна повірити.
Три аналізи цього проєкту зазнали невдачі саме через це, перш ніж проблему було вирішено.
Математика замість інтуїції
На основі цих даних розпочинається математичний аналіз:
- 397 011 пар значень було проаналізовано на предмет кореляції, найкращого розташування та напрямку.
- Перетиння показують, коли дві нормалізовані криві помінялися місцями — із рейтингом за прибутком пари та результатами діяльності у окремих періодах.
- Аналіз кривих шукає по всьому масиву даних точки максимумів, мінімумів, розворотів та сідловин. Основою є локальні поліноміальні апроксимації, а також стрибки нахилу та кривини.
- Порівняння ранніх індикаторів та випередження часових поясів: Токіо, Європа та Нью-Йорк — із чітким розмежуванням реального випередження та простого перекриття.
- Спектральний аналіз досліджує тривалість періодів, стабільність циклів, миттєві цикли та SSA.
- Аналіз руху капіталу розрізняє перерозподіл та приплив і відтік, а також виявляє можливі ознаки ротації.
- Аналіз «стада ботів» вимірює на основі тисяч подій, які фактичні сліди залишають на ринку публічно відомі тригери.
При цьому вирішальне питання ніколи не полягає лише в тому: чи існує закономірність? А в тому: чи щось від цього залишається, якщо перевірити це на даних, яких цей алгоритм раніше не бачив?
35 джерел новин — на будь-якій мові
Паралельно з котируваннями система щогодини аналізує новини. Наразі це 35 джерел з одинадцяти регіонів та 11 644 статті.
Серед них — Reuters, WSJ, FT, CNBC, MarketWatch, Handelsblatt, NZZ, Der Standard, Nikkei, South China Morning Post, Economic Times, CoinDesk та Cointelegraph. До них додаються ФРС, ЄЦБ, Банк Англії, БМР та SEC, а також UN News для світових подій.
Ключовим моментом є мовна незалежність. Ця
модель вбудовування bge-m3 є багатомовною: німецький
запит знаходить також японську новину, без будь-якого перекладу
. Етапу перекладу немає, оскільки він не потрібен — вектори
знаходяться в одному просторі.
Соціальні канали наразі ще не включені. Рівень стрічки новин в принципі може приймати будь-яке джерело RSS або Atom. Технічне розширення є незначним; власне робота полягає в тому, щоб виміряти якість сигналу.
Коли сьогоднішнє повідомлення стикається з учорашніми дослідженнями
У тому самому векторному просторі знаходиться й фахова література: 55 джерел, що містять 42 219 уривків, кожен із яких має джерело, сторінку та текстовий анкор.
Серед них:
- 41 робота з arXiv про лімітні книги замовлень, статистичну арбітраж, ринковий вплив, стратегії виконання та глибоке навчання в торгівлі,
- 12 класичних праць, що перебувають у загальному доступі, серед яких Лефевр, Селден, Гарпер, Клюс, Крамп, Гібсон, Лоусон, Райс, Бранденбург, Батлер та Френсіс,
- дисертація про мікроструктуру ринку та алгоритмічну торгівлю,
- робочий документ БМР щодо високочастотної торгівлі.
Новини та література не існують у відокремлених «силосах». Питання щодо аверсії до збитків знаходить відповідне місце в підручнику та, водночас, у сьогоднішньому ранковому повідомленні — без того, щоб хтось вручну створив цей зв’язок.
NVIDIA Nemotron: пояснювач, а не оракул
nemotron3:33b відповідає на запитання щодо прогнозів,
подій на кривих, зв’язків та накопичених знань. При цьому діє
суворе правило: модель не має права вигадувати жодного числа.
Кожне число походить із виклику інструменту. Ім’я, аргументи та результат цього виклику вказані під кожною відповіддю. Хто не довіряє якомусь твердженню, може перевірити.
Nemotron відповідає мовою запитання. При цьому він є саме пояснювачем, а не оракулом: модель зчитує наявні прогнози, класифікує їх і пояснює взаємозв’язки. Вона сама не генерує прогнози. Тому стовп «Міркування» також не має впливу на результат.
Що створюється щодня
Наразі система сформувала 978 837 прогнозів у реальному часі для семи часових горизонтів — від 24 годин до одного року. 303 465 із них вже було проаналізовано порівняно з курсом, який фактично склався згодом.
Щоденно на їх основі створюється:
- ринковий щоденник, який об’єднує інформацію про те, що змінилося, про що повідомлялося та які результати дають відповідні вимірювання,
- щоденний огляд помітних моментів, зважених за ступенем помітності та виміряною прибутковістю відповідного сегмента,
- тренди, відхилення та прогнози з їхньою видимою якістю.
Журнал свідомо пишеться без використання мовної моделі. Кожне число походить із запиту; речення навколо нього є шаблоном, а не вільно сформованим текстом.
Причина цього дуже конкретна: менша модель одного разу інтерпретувала коефіцієнт помилок 1,0034 як «майже ідеальний» і, таким чином, стверджувала протилежне тому, що видавав інструмент. Те, що потрапляє в журнал або блог, має залишатися перевіреним.
Найважливіше: що з цього дійсно працює?
Кожен прогноз оцінюється порівняно з курсом, який фактично реалізувався. Не в рамках ретроспективного розрахунку, а порівняно з курсами, які жодна модель цього додатка ніколи не бачила.
Коефіцієнт влучності, коефіцієнт помилок та очікуване значення з урахуванням витрат відображаються для кожного значення та кожного горизонту безпосередньо в інтерфейсі — поруч із прогнозом, до якого вони відносяться.
Це також є причиною, чому CRSOFT.StockCrawler не надає жодних рекомендацій щодо купівлі. Той, хто бачить виміряну якість прогнозу прямо поруч, не потребує готової рекомендації. Він може прийняти власне рішення — на основі, яку можна перевірити розрахунками.
Вісім стовпів, але жодного значення без підтвердження
Кожен із восьми стовпів ставить інше запитання щодо тих самих даних. Кожен із них можна активувати та зважити. Але жоден із них не впливає на результат без виміряної підтримки.
Зважування здійснюється за допомогою регулятора × заслуга. Заслуга походить із заблокованої області — а не з налаштувань.
| Стовп | Завдання |
|---|---|
| Навчання курсу | П’ять часткових моделей, ваги яких постійно коригуються на основі власної похибки. Єдиний стовп, який наразі враховується у збережених прогнозах. |
| Математичний аналіз | Спектр, стабільність циклів, миттєвий цикл, SSA та індекс Херста — обробка сигналів на окремому ряді. |
| Рух капіталу | Перерозподіл за надходженнями та відтоками, підозра на ротацію та групи, що мають незмінну суму. |
| Глибоке навчання | Три моделі ONNX з окремими діапазонами горизонтів, що обробляються на процесорі. |
| Знання | Вбудована фахова література та виміряні шаблони поведінки ботів як внесок. |
| Семантика | Настрій новин, відкалібрований відповідно до отриманої згодом прибутковості. |
| Міркування | Пояснює, але не бере до уваги. |
| Аналіз кривих | Точки максимуму, мінімуму, розвороту та сідла за допомогою локального поліноміального апроксимування. |
Від аналізу до віртуального портфеля
CRSOFT.StockCrawler не обмежується лише кореляціями та прогнозами. Ця програма також досліджує, як сигнали поводяться в більш реалістичних умовах.
Аналіз
- кореляції та ранніх індикаторів на основі 397 011 проаналізованих пар, включно з найкращим лагом та напрямком
- Перетини нормалізованих кривих із рейтингом за прибутком пари та ефективністю за окремими періодами
- Аналіз кривих для всього портфеля, з каузальним або центрированим згладжуванням, з урахуванням зв’язків між одночасними подіями
- світовий масив даних та часові пояси з чітким розмежуванням попереднього періоду та простого перекриття
- «Стадо» ботів: вимірювані сліди загальновідомих тригерів, таких як ковзні середні, RSI та Боллінджера
- Зворотний висновок: чи може сигнал бути придатним, якщо його перевернути?
Прогноз та якість
- Сім горизонтів, для кожного значення та цільової дати — саме одне знедубльоване спостереження
- Крива навчання: чи справді система стає кращою?
- Змішане порівняння: чи дає об’єднання стовпців взагалі якийсь ефект?
- Ретроспектива як сукупна перевага над стагнацією
Торгівля та депозит
- Денна торгівля: не «Що мені купити?», а: Чи приносить ринок сьогодні взагалі прибуток від торгівлі протягом дня, після вирахування комісій?
- Обмін: пропозиції щодо перерозподілу з урахуванням власного портфеля
- Довгострокова стратегія: прибутковість, найглибші падіння та кошики — з помітним спотворенням виживання
- Віртуальний портфель: розрахункові рахунки в євро та доларах США, комісії за кожну операцію, журнал обліку та динаміка активів
- «Автопілот» із чотирма стратегіями:
streng,aktiv,haltenтаinvers. Стратегія інверсії використовує найнижче оцінені активи як контрольний механізм. Спочаткуaktiv − inversпоказує інформативність сигналу. - Нові надходження: попередні оголошення з календаря IPO Nasdaq та каталогу лістингу Binance — як повна кохорта, включаючи невдалі спроби
Працює локально, відкритий для розширення
Весь процес відбувається на одному комп’ютері. Котирування, прогнози та оцінки оновлюються щогодини; універсум, аналіз, нові записи та автопілот — щодня.
Інтерфейс із 2 272 текстами повністю доступний на німецькій та англійській мовах. Додавання ще однієї мови технічно полягає лише в додаванні додаткового XML-файлу.
Дві ролі захищаються не лише за допомогою списку сторінок, а безпосередньо на рівні HTTP-методу. Таким чином, це правило поширюється також на кінцеві точки, які на сьогодні ще навіть не існують.
Що заплановано далі
Проєкт є відкритим, але ще не завершеним. У списку, серед іншого, знаходяться:
- розширення тестового покриття для
Ingest.Core/Analysis, - усунення заторів у черзі оцінювання,
- відсіювання значень без даних про курс,
- зберігання даних доступу в «User Secrets», а не в
appsettings.json, - соціальні мережі як додаткові джерела,
- підключення до SEC EDGAR,
- короткі продажі у віртуальному депозитарії,
- узгоджені формати чисел та дат для інших мов.
Саме математика свідомо не залежить від інших компонентів і добре піддається тестуванню. Тому покриття тестів є одним із найвдячніших пунктів для початку роботи для нових учасників.
Чим CRSOFT.StockCrawler не є:
Це не торгова система і не інвестиційна консультація. Ця програма ніде не вказує, що саме слід купувати. Вона відповідає на попереднє запитання:
Що взагалі можна виміряти — і чи окупає це витрати?
Немає прогнозу без вимірювання його якості. Кожне число, яке відображає додаток, ґрунтується на вимірюванні. Це вимірювання знаходиться там, де хтось інакше сприйняв би число за чисту монету: безпосередньо поруч із ним.
Те, що в обмеженій зоні є виправданим, а що ні, визначає його вагу в кінцевому результаті. Стовп без підтвердження нічого не рухає — навіть якщо його регулятор встановлений на сто.
Можливо, саме в цьому полягає найбільша відмінність цього проєкту: CRSOFT.StockCrawler не намагається продавати впевненість. Він робить невизначеність видимою, перевіряє твердження на основі невідомих даних і відкрито показує, де математика, знання та штучний інтелект роблять вимірюваний внесок – а де ні.
Повні ряди вимірювань — для кожного стовпчика, кожного горизонту та
включно з методами, які не дали результатів, — наведені в
технічній документації в розділі CRS.StockCrawler/docs/ та в
самій програмі.
CRSOFT.StockCrawler — це відкритий, локально керований аналітичний проєкт. Він не є інвестиційною консультацією та не містить рекомендацій щодо купівлі чи продажу.
免费开源仓库 https://github.com/chrisreiter/CRSOFT.StockCrawler.AI
CRSOFT.StockCrawler: 当数据、新闻和专业知识共同解读市场时
如果有一个系统能够对来自17个交易所的股票、ETF、加密货币和 指数进行数学分析——同时还能 理解来自全球的股市新闻及相关专业文献,那会怎样?
不受语言限制。仅需一台计算机。无需云端。开放且免费。
这正是 CRSOFT.StockCrawler。
该系统将行情数据、数学分析、新闻 和专业文献整合到一个共同的向量空间中。NVIDIA Nemotron负责将这些信息整合在一起——并且必须对所使用的每个数字提供依据。
具体数据如下:
641 个数值 · 390 万根价格K线 · 397,011 对经分析的 数值对 · 35 个新闻来源 · 42,219 个专业文献段落 · 978,837 项预测。
正是基于这一架构,供应商才收取五位数的年度许可费。
但接下来是许多供应商未能提供的部分: 衡量其中哪些内容真正有效。所有内容都会 与一个“排除区”进行比对。如果某项方法毫无成效, 系统界面会明确显示——而非藏在细则的细小字里。
整个流程集成于一个 系统中
   Kurse          17 Börsen, live, stündlich, zurück bis 2001
      ↓
   Mathematik     Korrelationen · Kreuzungen · Vorlauf · Kurvendiskussion
      ↓           Spektralanalyse · Kapitalfluss · Zeitzonen
   Nachrichten    35 Quellen weltweit, in jeder Sprache
      ↓
   Vektorraum     sprachunabhängig – gemeinsam mit der Fachliteratur:
      ↓           arXiv, Dissertationen, Klassiker
   Reasoning      NVIDIA Nemotron, das jede Zahl belegen muss
      ↓
   Täglich        Journal · Auffälligkeiten · Trends · Prognosen
来自17个交易场所的641项资产
起点是405只股票、109种加密货币、107只基金和ETF,以及20个指数和外汇。
数据来源包括Xetra以及巴黎、伦敦、苏黎世、东京、阿姆斯特丹、维也纳、米兰、马德里、斯德哥尔摩、香港和美国各证券交易所。 该数据库总计包含 3,941,331 条 以日度和小时度为分辨率的报价数据——部分数据可追溯至 2001年。每小时都有新数据加入。
不同证券交易所拥有不同的交易日历, 乍听之下似乎只是个细节。实际上,这却是最常见的 陷阱之一:如果仅基于原始的时间网格进行计算,很容易就会误将日历数据 当作市场数据——而且这种误判的结论足够令人信服,以至于让人深信不疑。
在该问题得到解决之前,该项目中的三项分析正是因这一原因而失败。
依靠数学而非直觉
基于这些数据,数学分析正式开始:
- 对397,011组数据对进行了相关性、最佳 时机和方向的分析。
- 交叉点显示了两条标准化曲线何时互换位置——并按各时间段内的对赢率和表现表现,列出了排名。
- 曲线分析在整个数据集中搜寻高点、低点、转折点和鞍点。其基础是局部多项式拟合以及斜率和曲率的突变。
- 比较先行指标和时区领先性: 东京、欧洲和纽约——清晰区分真正的领先性 与单纯的重叠现象。
- 频谱分析考察周期长度、 周期稳定性、瞬时周期和SSA。
- 资金流分析区分了再分配与入流和流出,并识别出可能的轮动迹象。
- 对机器人群的分析通过数千次事件, 衡量公开已知的触发因素在市场上实际留下的痕迹。
关键问题绝不仅仅是:是否存在某种模式? 而是:当用该方法此前未曾接触过的数据进行验证时,这种模式是否依然成立? 35个新闻来源——
35个新闻来源—— 涵盖所有语言
在追踪行情的同时,系统每小时都会抓取新闻。 目前共有来自11个地区的35个新闻来源,以及 11,644篇报道。
其中包括路透社、华尔街日报、金融时报、CNBC、MarketWatch、《商报》、NZZ、 《标准报》、《日经新闻》、《南华早报》、《经济时报》、CoinDesk 和Cointelegraph。此外还有美联储、欧洲央行、英格兰银行、国际清算银行和美国证券交易委员会(SEC) 以及报道国际事件的联合国新闻。
关键点在于其语言独立性。该 嵌入式模型 bge-m3 支持多语言:一个德语的 查询也能找到日语的新闻报道,而无需任何地方进行翻译。没有翻译步骤,因为根本不需要——这些 向量位于同一个空间中。
目前尚未包含社交媒体渠道。信息流层 原则上可以接收任何RSS或Atom源。因此,技术上的 扩展工作量很小;真正的工作在于测量 信号质量。
当 今天的新闻与昨天的研究相遇时
专业文献也位于同一个向量空间中:55个来源,共42,219个段落,每个段落都包含来源、页码和文本锚点。
其中包括:
- 41篇关于限价订单簿、 统计套利、市场影响、执行策略以及交易中深度学习(Deep Learning)的 arxiv 论文,
- 12部公有领域经典著作,包括勒菲弗尔(Lefèvre)、塞尔登(Selden)、 哈珀(Harper)、克鲁斯(Clews)、克鲁普(Crump)、吉布森(Gibson)、劳森(Lawson)、赖斯(Rice)、勃兰登堡(Brandenburg)、巴特勒(Butler)和 弗朗西斯(Francis)的作品,
- 一篇关于市场微观结构和算法交易的博士论文,
- 一份关于高频交易的国际清算银行(BIZ)工作论文。
新闻与文献并非各自为政。一个关于损失厌恶的问题既能在教科书中找到相应的章节,又能与今早的新闻报道相呼应——而这一切无需任何人手动建立联系。
NVIDIA Nemotron:解释者而非预言家
nemotron3:33b 会回答有关预测、 曲线事件、关联性以及积累知识的问题。在此过程中,有一条 铁律:模型不得编造任何数字。
每个数字都来自工具调用。该调用的名称、参数和 结果都会显示在每个答案下方。如果对某个陈述 存疑,可以自行核查。
Nemotron 会使用提问时的语言进行回答。 在此过程中,它明确地扮演着“解释者”而非“预言家”的角色:该模型读取、整理现有预测,并阐明其中的关联。它本身并不生成预测。因此,“推理”支柱在结果中也不占任何权重。
每日产出
该系统迄今已生成978,837条实时预测, 涵盖从24小时到一年的七个预测时段。 其中303,465条已根据后来 实际出现的股价进行了评估。
由此每天生成:
- 一份市场日志,汇总了哪些因素发生了变动、相关报道内容,以及相关指标的测量结果; 以及
- 一份每日异常点概览, 按异常程度与各支柱的测算收益相乘进行加权,
- 趋势、异常情况及预测,并附有其可见的质量评级。
该日志特意不使用语言模型来编写。 每个数字都来自一次查询;围绕该数字的句子是一个 模板,而非自由生成的文本。
原因非常具体:一个较小的模型曾将 1.0034的误差比解释为“近乎完美”,并因此得出了与工具输出结果相反的结论。进入日志或博客的内容必须保持可复现性。
最重要的部分:其中哪些内容真正有效?
每项预测都会与实际发生的价格进行比对。并非通过回溯计算,而是与该应用中任何模型都从未见过的价格进行比对。
命中率、误差率以及扣除成本后的期望值,会按每只股票和每个预测周期,直接显示在界面上—— 紧邻它们所对应的预测结果。
这也是 CRSOFT.StockCrawler 不提供任何买入建议的原因。那些能直接从预测的评估结果中看清其准确性的人,根本不需要现成的建议。他们可以自己做出决策——基于可验证的依据。——
八大支柱,但 没有经证实的依据,就没有权重
这八大支柱各自针对同一组数据提出不同的问题。 每个支柱都可以启用并进行权重设置。但若没有经过测量的支撑,任何支柱都无法产生影响。
加权公式为“调节器 × 贡献值”。贡献值来自限制范围——而非预设值。
| 支柱 | 任务 |
|---|---|
| 课程学习 | 五个子模型,其权重会根据自身的误差 持续进行调整。这是目前唯一一个会纳入已存储的 预测结果的支柱。 |
| 数学分析 | 频谱、周期稳定性、瞬时周期、SSA 和赫斯特指数—— 针对单个数据序列的信号处理。 |
| 资金流 | 针对资金流入与流出的再分配、资金循环嫌疑以及总和不变的组。 |
| 深度学习 | 三个基于独立时间段的 ONNX 模型,在处理过程中运行于 CPU 上。 |
| 知识 | 嵌入的专业文献和测得的机器人行为模式作为 输入。 |
| 语义 | 新闻情绪,根据随后实现的 回报率进行校准。 |
| 推理 | 提供解释,但不参与计算。 |
| 曲线分析 | 通过局部多项式拟合确定高点、低点、转折点和鞍点。 |
从分析到虚拟投资组合
CRSOFT.StockCrawler 不仅限于相关性分析和预测, 该应用程序还会研究信号在 更贴近现实的条件下表现如何。
分析
- 基于397,011组已评估交易对的相关性与先行指标, 包括最佳入场时机和方向
- 标准化曲线的交叉点,按交易对收益和在不同时间段内的表现进行排名,以及 在不同时间段内的表现
- 针对整个数据集的曲线分析,采用因果或中心化平滑处理,并关联同时发生的事件
- 全球数据集和时区,明确区分先行指标与 单纯重叠
- 机器人群:可测量的、公开已知的触发因素痕迹,例如 移动平均线、RSI 和布林带
- 反向推论:如果将信号反转,它是否就有效了?
预测与质量
- 七个时间维度,针对每个标的和目标日,各有一条经过去冗余处理的 观测数据
- 学习曲线:系统是否真的在不断优化?
- 混合比较:合并各柱状图是否真的有 任何意义?
- 回顾即相对于停滞状态的累计领先优势
交易与投资组合
- 日内交易:不是“我该买什么?”,而是: 在扣除手续费后,今天的市场是否真的支持日内交易?
- 换仓:基于自身持仓的 资产配置建议
- 长期投资:收益率、最低跌幅和投资组合—— 带有明显的生存偏差
- 虚拟投资组合:以欧元和美元计价的结算账户、每笔交易费用、记账日志及资产变动情况
- 四种策略的自动交易:
streng,aktiv,halten以及invers. 该反向策略将估值最低的标的作为对冲。 首先aktiv − invers显示了该信号的信息含量。 - 新上市:来自纳斯达克IPO日历和币安上市目录的预告——作为完整的 数据集,包括未成功上市的情况
本地运行,支持开放式扩展
整个流程在单台计算机上运行。股价、预测和估值每小时更新;投资组合、分析、新增标的和自动驾驶功能每日更新。
界面包含 2,272 篇文本,提供完整的德语和英语版本。从技术上讲,添加另一种语言仅需一个额外的 XML 文件。
两个角色不仅通过页面列表进行保护, 还直接基于HTTP方法进行保护。因此,该规则同样适用于 目前尚不存在的端点。
下一步计划
该项目处于开放状态,但尚未完成。待办事项包括:
- 提高测试覆盖率,以
Ingest.Core/Analysis, - 解决评分队列中的拥塞问题,
- 筛选出不含课程数据的值,
- 将访问凭据存储在“用户密钥”中,而非
appsettings.json, - 作为补充数据源,
- 对接SEC EDGAR系统,
- 虚拟投资组合中的卖空交易,
- 为其他语言适配的数字和日期格式。
尤其是数学部分,其设计刻意避免了依赖性,且易于测试。 因此,测试覆盖率是新贡献者最容易入手的切入点之一。
CRSOFT.StockCrawler 并非以下内容: Simplified Chinese (Mainland)
既非交易系统,也非投资建议。该应用在任何地方都未指出应购买什么。它 回答的是更根本的问题:
究竟能衡量什么——以及它是否值得投入成本?
没有经过质量测量的预测是不存在的。该应用显示的每个数字, 背后都有一项测量数据支撑。这项测量数据位于 人们通常会直接采信该数字的地方:就在 数字的旁边。
在受限领域内,某项方法能否支撑其价值,将决定其对结果的权重。缺乏实证支撑的支柱无法推动任何进展——即使其调节器调到了最大值也是如此。
也许这正是该项目最大的不同之处: CRSOFT.StockCrawler 并不试图兜售确定性。它让 不确定性显而易见,对基于未知数据的论断进行验证,并公开展示 数学、知识和人工智能在哪些方面做出了可衡量的贡献—— 以及在哪些方面未能做到。
完整的测量数据集——按每根柱子、每个时间段,以及 包括那些未产生有效结果的方法——均收录于 技术文档中的 CRS.StockCrawler/docs/ 以及在应用程序本身中。
CRSOFT.StockCrawler 是一个开放的、本地运行的分析项目。它不构成投资建议,也不构成任何买入或卖出建议。
gratis & open-source repository https://github.com/chrisreiter/CRSOFT.StockCrawler.AI
CRSOFT.StockCrawler: Wanneer cijfers, nieuws en vakkennis samen de markt analyseren
Wat als één enkel systeem aandelen, ETF's, cryptovaluta's en indexen van 17 beurzen wiskundig analyseert – en tegelijkertijd beursnieuws uit de hele wereld en de vakliteratuur daarover begrijpt?
Taalonafhankelijk. Op één computer. Zonder cloud. Open en gratis.
Dat is precies wat CRSOFT.StockCrawler is.
Het systeem combineert koersgegevens, wiskundige analyses, nieuws en vakliteratuur in één gezamenlijke vectorruimte. NVIDIA Nemotron brengt deze informatie samen – en moet elk gebruikt getal onderbouwen.
In cijfers betekent dit:
641 waarden · 3,9 miljoen koersbalken · 397.011 geanalyseerde waardeparen · 35 nieuwsbronnen · 42.219 fragmenten uit vakliteratuur · 978.837 prognoses.
Dat is de opzet waarvoor aanbieders jaarlijkse licenties met vijfcijferige bedragen vragen.
Maar dan komt het deel dat velen daarvan niet leveren: het meten van wat daar daadwerkelijk van werkt. Alles wordt getoetst aan een uitsluitingscriterium. En als een methode niets oplevert, wordt dat openlijk in de interface vermeld – niet in de kleine lettertjes.
De hele keten in één systeem
   Kurse          17 Börsen, live, stündlich, zurück bis 2001
      ↓
   Mathematik     Korrelationen · Kreuzungen · Vorlauf · Kurvendiskussion
      ↓           Spektralanalyse · Kapitalfluss · Zeitzonen
   Nachrichten    35 Quellen weltweit, in jeder Sprache
      ↓
   Vektorraum     sprachunabhängig – gemeinsam mit der Fachliteratur:
      ↓           arXiv, Dissertationen, Klassiker
   Reasoning      NVIDIA Nemotron, das jede Zahl belegen muss
      ↓
   Täglich        Journal · Auffälligkeiten · Trends · Prognosen
641 waarden van 17 beurzen
Het uitgangspunt zijn 405 aandelen, 109 cryptovaluta’s, 107 fondsen en ETF’s, evenals 20 indices en valuta’s.
De gegevens zijn onder andere afkomstig van Xetra en uit Parijs, Londen, Zürich, Tokio, Amsterdam, Wenen, Milaan, Madrid, Stockholm, Hongkong en van de Amerikaanse beurzen. In totaal omvat de database 3.941.331 koersbalken met een dag- en uurresolutie – deels teruggaand tot het jaar 2001. Elk uur komen er nieuwe bij.
Dat verschillende beurzen verschillende handelskalenders hebben, klinkt op het eerste gezicht als een detail. In feite is het een van de meest voorkomende valkuilen: wie op basis van het ruwe tijdsraster berekeningen maakt, meet al snel de kalender in plaats van de markt – en wel zo overtuigend dat men het gelooft.
Drie analyses van dit project zijn precies hieraan mislukt, voordat het probleem was opgelost.
Wiskunde in plaats van intuïtie
Op basis van deze gegevens begint de wiskundige analyse:
- 397.011 waardeparen werden geanalyseerd op correlatie, beste positie en richting.
- Kruispunten geven aan wanneer twee genormaliseerde curven van plaats zijn gewisseld – met een ranglijst op basis van winst per paar en prestaties in afzonderlijke tijdsperioden.
- De curveanalyse zoekt in de gehele dataset naar hoogte-, diepte-, keer- en zadelpunten. De basis hiervoor wordt gevormd door lokale polynomaanpassingen en uitstapels in helling en kromming.
- Vroegtijdige indicatoren en de voorloop van tijdzones vergelijken: Tokio, Europa en New York – met een duidelijke scheiding tussen echte voorloop en louter overlapping.
- De spectrale analyse onderzoekt periodelengtes, cyclusstabiliteit, momentane cycli en SSA.
- De kapitaalstroom maakt onderscheid tussen herverdeling enerzijds en to- en afvloeiingen anderzijds en signaleert mogelijke rotatievermoedens.
- De analyse van de bot-kuddes meet aan de hand van duizenden gebeurtenissen wat publiekelijk bekende triggers daadwerkelijk in de markt achterlaten.
De cruciale vraag is daarbij nooit alleen: is er een patroon? Maar: blijft er iets van over als men het toetst aan gegevens die de methode nog niet eerder heeft gezien?
35 nieuwsbronnen – in elke taal
Parallel aan de koersen leest het systeem elk uur nieuwsberichten in. Momenteel zijn dat 35 bronnen uit elf regio’s en 11.644 artikelen.
Daartoe behoren Reuters, WSJ, FT, CNBC, MarketWatch, Handelsblatt, NZZ, Der Standard, Nikkei, South China Morning Post, Economic Times, CoinDesk en Cointelegraph. Daarnaast zijn er de Fed, de ECB, de Bank of England, de BIS en de SEC evenals UN News voor wereldwijde gebeurtenissen.
Het belangrijkste punt is de taalonafhankelijkheid. Het inbeddingsmodel bge-m3 is meertalig: een Duitse vraag vindt ook een Japans bericht, zonder dat er ergens wordt vertaald. Er is geen vertaalstap, omdat die niet nodig is – de vectoren bevinden zich in dezelfde ruimte.
Sociale kanalen zijn momenteel nog niet opgenomen. De feed-laag kan in principe elke RSS- of Atom-bron opnemen. De technische uitbreiding is dus klein; het eigenlijke werk bestaat uit het meten van de signaalkwaliteit.
Wanneer het nieuws van vandaag het onderzoek van gisteren ontmoet
In dezelfde vectorruimte bevindt zich ook de vakliteratuur: 55 bronnen met 42.219 paragrafen, elk met bron, pagina en tekstanker.
Hieronder vallen:
- 41 arxiv-artikelen over limit order books, statistische arbitrage, markteffect, uitvoeringsstrategieën en deep learning in de handel,
- 12 klassiekers in het publieke domein, waaronder Lefèvre, Selden, Harper, Clews, Crump, Gibson, Lawson, Rice, Brandenburg, Butler en Francis,
- een proefschrift over marktmicrostructuur en algoritmische handel,
- een BIZ-werkdocument over hoogfrequente handel.
Nieuws en literatuur staan niet in afzonderlijke silo’s. Een vraag over verliesaversie vindt de juiste plek in het leerboek en tegelijkertijd in het nieuwsbericht van vanochtend – zonder dat iemand dit verband met de hand zou hebben gelegd.
NVIDIA Nemotron: uitlegger in plaats van orakel
nemotron3:33b beantwoordt vragen over prognoses, curvegebeurtenissen, verbanden en de verzamelde kennis. Daarbij geldt een strikte regel: het model mag geen getal verzinnen.
Elk getal is afkomstig uit een toolaanroep. De naam, argumenten en uitkomst van deze aanroep staan onder elk antwoord vermeld. Wie een uitspraak wantrouwt, kan dit nakijken.
Nemotron antwoordt in de taal van de vraag. Het is daarbij uitdrukkelijk een uitlegger, geen orakel: het model leest bestaande prognoses, ordent ze en legt verbanden uit. Het genereert de prognoses niet zelf. Daarom heeft de ‘reasoning’-pijler ook geen invloed op het resultaat.
Wat er elke dag ontstaat
Het systeem heeft inmiddels 978.837 live-prognoses over zeven tijdshorizonten gegenereerd – van 24 uur tot een jaar. 303.465 daarvan zijn al vergeleken met de koers die later daadwerkelijk is gerealiseerd.
Hieruit ontstaat dagelijks:
- een marktdagboek dat samenvat wat er heeft bewogen, wat daarover is gemeld en wat de meting daarover oplevert,
- een dagelijks overzicht van de opvallende punten, gewogen naar opvallendheid maal de gemeten opbrengst van de betreffende pijler,
- trends, opvallende punten en prognoses met hun zichtbare kwaliteit.
Het dagboek wordt bewust zonder taalmodel geschreven. Elk getal is afkomstig uit een query; de zin eromheen is een sjabloon en geen vrij gegenereerde tekst.
De reden hiervoor is heel concreet: een kleiner model interpreteerde ooit een foutverhouding van 1,0034 als „bijna perfect“ en beweerde daarmee het tegenovergestelde van de tool-uitvoer. Wat in een dagboek of een blog terechtkomt, moet controleerbaar blijven.
Het belangrijkste gedeelte: wat levert hier echt iets op?
Elke prognose wordt getoetst aan de koers die daadwerkelijk is gerealiseerd. Niet in een terugrekening, maar aan koersen die geen enkel model van deze toepassing ooit heeft gezien.
Het percentage juiste voorspellingen, de foutenverhouding en de verwachte waarde na aftrek van kosten staan per waarde en per tijdshorizon direct in de interface – naast de prognose waarop ze betrekking hebben.
Dat is ook de reden waarom CRSOFT.StockCrawler geen koopaanbevelingen geeft. Wie de gemeten kwaliteit van een prognose direct naast zich ziet staan, heeft geen kant-en-klare aanbeveling nodig. Hij kan zijn eigen beslissing nemen – op een basis die naverifieerbaar is.
Acht pijlers, maar geen gewicht zonder onderbouwing
Elk van de acht pijlers stelt een andere vraag aan dezelfde gegevens. Elke pijler kan worden ingeschakeld en gewogen. Maar geen enkele pijler heeft invloed zonder gemeten onderbouwing.
Er wordt gewogen met regelaar × verdienste. De verdienste komt uit het geblokkeerde bereik – niet uit de instelling.
| Pijler | Opdracht |
|---|---|
| Koers leren | Vijf deelmodellen waarvan de wegingen voortdurend worden bijgesteld op basis van de eigen fout. De enige pijler die momenteel wordt meegenomen in de opgeslagen prognoses. |
| Wiskundige analyse | Spectrum, cyclusstabiliteit, momentane cyclus, SSA en Hurst – signaalverwerking op de afzonderlijke reeks. |
| Kapitaalstroom | Herverdeling tegen in- en uitstroom, vermoeden van rotatie en groepen met behoud van de som. |
| Deep learning | Drie ONNX-modellen over afzonderlijke horizonbanden, tijdens de verwerking op de CPU. |
| Kennis | Geïntegreerde vakliteratuur en gemeten botpatronen als bijdrage. |
| Semantiek | Tone van het nieuws, gekalibreerd aan de hand van het daarna behaalde rendement. |
| Redenering | Verklaart, maar houdt er geen rekening mee. |
| Discussie over de curve | Hoog-, laag-, keer- en zadelpunten via lokale polynoomaanpassing. |
Van analyse tot virtuele portefeuille
CRSOFT.StockCrawler beperkt zich niet tot correlaties en prognoses . De applicatie onderzoekt ook hoe signalen zich gedragen onder realistischere omstandigheden.
Analyse
- Correlaties en vroege indicatoren op basis van 397.011 geëvalueerde paren, inclusief beste timing en richting
- kruisingen van genormaliseerde curven met ranglijst op basis van paarsgewinst en prestaties uit afzonderlijke periodes
- Curvebespreking over de gehele portefeuille, causaal of gecentreerd afgevlakt, met koppeling van gelijktijdige gebeurtenissen
- Wereldwijde populatie en tijdzones met een duidelijke scheiding tussen voorlopen en loutere overlapping
- Bot-kudde: meetbare sporen van algemeen bekende triggers zoals voortschrijdende gemiddelden, RSI en Bollinger
- Omgekeerde redenering: is een signaal misschien bruikbaar als je het omdraait?
Prognose en kwaliteit
- zeven horizonten, per waarde en streefdatum precies één ontdubbelde waarneming
- Leercurve: Wordt het systeem daadwerkelijk beter?
- Gemengde vergelijking: levert het samenvoegen van de kolommen überhaupt iets op?
- Terugblik als geaccumuleerde voorsprong ten opzichte van stilstand
Handel en effectenportefeuille
- Daghandel: niet „Wat moet ik kopen?“, maar: Levert de markt vandaag überhaupt winst op binnen één dag, na aftrek van kosten?
- Herschikking: voorstellen voor herschikking op basis van de eigen portefeuille
- Lange termijn: rendementen, diepste dalingen en mandjes – met zichtbare overlevingsvertekening
- Virtuele portefeuille: afrekeningsrekeningen in EUR en USD, kosten per transactie, boekingsjournaal en vermogensontwikkeling
- Autopiloot met vier strategieën:
streng,aktiv,halteneninvers. De omgekeerde strategie houdt de laagst gewaardeerde aandelen aan als tegenwicht. Eerstaktiv − inverstoont de informatieve waarde van het signaal. - Nieuwe toevoegingen: aankondigingen uit de Nasdaq-IPO-kalender en de listingcatalogus van Binance – als volledige cohort, inclusief de mislukkingen
Lokaal geëxploiteerd, openlijk uitbreidbaar
Het gehele proces draait op één computer. Koersen, prognoses en waarderingen worden elk uur bijgewerkt; universum, analyse, nieuwe toevoegingen en autopiloot dagelijks.
De interface is met 2.272 teksten volledig beschikbaar in het Duits en Engels. Een extra taal bestaat technisch gezien slechts uit een extra XML-bestand.
Twee rollen worden niet alleen via een lijst met pagina’s beveiligd, maar direct op basis van de HTTP-methode. Daardoor geldt de regel ook voor eindpunten die op dit moment nog helemaal niet bestaan.
Wat er vervolgens op de planning staat
Het project is open, maar nog niet afgerond. Op de lijst staan onder andere: meer testdekking voor
- meer testdekking voor
Ingest.Core/Analysis, - het oplossen van een opstopping in de beoordelingswachtrij,
- het verwijderen van waarden zonder koersgegevens,
- toegangsgegevens in User Secrets in plaats van in
appsettings.json, - sociale kanalen als aanvullende bronnen,
- de koppeling met SEC EDGAR,
- shorttransacties in de virtuele portefeuille,
- gekoppelde getal- en datumformaten voor andere talen.
Juist de wiskunde is bewust onafhankelijk van andere onderdelen en goed te testen. De testdekking is daarmee een van de meest toegankelijke instapmomenten voor nieuwe bijdragers.
Wat CRSOFT.StockCrawler niet is: Geen handelssysteem en geen beleggingsadvies. De
Geen handelssysteem en geen beleggingsadvies. De applicatie geeft op geen enkel moment aan wat er gekocht moet worden. Ze beantwoordt de vraag die daaraan voorafgaat:
Wat valt er überhaupt te meten – en weegt het op tegen de kosten?
Er is geen prognose zonder de gemeten kwaliteit ervan. Elk getal dat de applicatie weergeeft, is gebaseerd op een meting. Deze meting staat daar waar iemand het getal anders voor waar zou aannemen: direct ernaast.
Wat een procedure in het verboden gebied oplevert en wat niet, bepaalt het gewicht ervan in het resultaat. Een pilaar zonder bewijs brengt niets in beweging – zelfs niet als de regelaar op honderd staat.
Misschien is dat wel het grootste verschil van dit project: CRSOFT.StockCrawler probeert geen zekerheid te verkopen. Het maakt onzekerheid zichtbaar, toetst beweringen aan de hand van onbekende gegevens en laat openlijk zien waar wiskunde, kennis en AI een meetbare bijdrage leveren – en waar niet.
De volledige meetreeksen – per kolom, per horizon en inclusief de methoden die niets hebben opgeleverd – staan in de technische documentatie onder CRS.StockCrawler/docs/ en in de applicatie zelf.
CRSOFT.StockCrawler is een open, lokaal beheerd analyseproject. Het vormt geen beleggingsadvies en geen koop- of verkoopaanbeveling.
ücretsiz ve açık kaynak depo https://github.com/chrisreiter/CRSOFT.StockCrawler.AI
CRSOFT.StockCrawler: Rakamlar, haberler ve uzmanlık bir araya gelerek piyasayı yorumladığında
Tek bir sistem, 17 borsadaki hisse senetlerini, ETF'leri, kripto para birimlerini ve endeksleri matematiksel olarak analiz etse ve aynı zamanda dünyanın dört bir yanından gelen borsa haberlerini ve ilgili uzmanlık literatürünü de anlayabilseydi ne olurdu?
Dilden bağımsız. Tek bir bilgisayarda. Bulut olmadan. Açık ve ücretsiz.
CRSOFT.StockCrawler tam da budur.
Sistem, fiyat verilerini, matematiksel analizleri, haberleri ve teknik literatürü tek bir vektör uzayında birleştirir. NVIDIA Nemotron, bu bilgileri bir araya getirir – ve kullanılan her sayıyı kanıtlamak zorundadır.
Rakamlarla ifade edersek:
641 değer · 3,9 milyon fiyat çubuğu · 397.011 değerlendirilmiş değer çifti · 35 haber kaynağı · 42.219 uzmanlık literatürü bölümü · 978.837 tahmin.
Bu, sağlayıcıların beş haneli yıllık lisans ücretleri talep ettiği bir yapıdır.
Ancak işin, çoğunun sunmadığı kısmı da var: bunlardan hangilerinin gerçekten işe yaradığının ölçülmesi. Her şey, bir kontrol listesi ile karşılaştırılarak incelenir. Ve eğer bir yöntem sonuç vermezse, bu durum arayüzde açıkça belirtilir – küçük harflerle yazılmış metinlerde değil.
Tüm zincir tek bir sistemde
   Kurse          17 Börsen, live, stündlich, zurück bis 2001
      ↓
   Mathematik     Korrelationen · Kreuzungen · Vorlauf · Kurvendiskussion
      ↓           Spektralanalyse · Kapitalfluss · Zeitzonen
   Nachrichten    35 Quellen weltweit, in jeder Sprache
      ↓
   Vektorraum     sprachunabhängig – gemeinsam mit der Fachliteratur:
      ↓           arXiv, Dissertationen, Klassiker
   Reasoning      NVIDIA Nemotron, das jede Zahl belegen muss
      ↓
   Täglich        Journal · Auffälligkeiten · Trends · Prognosen
17 borsadan 641 varlık,
Başlangıç noktası 405 hisse senedi, 109 kripto para birimi, 107 fon ve ETF ile 20 endeks ve dövizdir.
Veriler, diğerlerinin yanı sıra Xetra'dan ve Paris, Londra, Zürih, Tokyo, Amsterdam, Viyana, Milano, Madrid, Stockholm, Hong Kong'dan ve ABD borsalarından gelmektedir. Toplamda portföy, günlük ve saatlik çözünürlükte 3.941.331 fiyat verisini içermektedir – bunların bir kısmı even as far back as 2001 yılına kadar uzanmaktadır. Her saat başı yenileri eklenmektedir.
Farklı borsaların farklı işlem takvimlerine sahip olması, ilk bakışta önemsiz bir ayrıntı gibi görünebilir. Oysa bu, en sık karşılaşılan tuzaklardan biridir: Ham zaman tablosu üzerinden hesaplama yapanlar, piyasayı değil takvimi ölçerler – ve bunu, inandırıcı bir şekilde yaparlar.
Bu projenin üç analizi, sorun giderilmeden önce tam da bu nedenle başarısız oldu.
Matematik yerine içgüdü
Matematiksel analiz bu veri temelinde başlar:
- 397.011 değer çifti, korelasyon, en iyi konum ve yön açısından değerlendirildi.
- Kesişme noktaları, iki normalleştirilmiş eğrinin ne zaman yer değiştirdiğini gösterir – çift kazancı ve ayrı zaman dilimlerinde gösterilen performansa göre sıralama da dahil. Eğri analizi, tüm portföy üzerinde yüksek, düşük, dönüm ve eyer noktalarını arar. Temelini, yerel polinom uyumlamaları ile eğim ve eğrilik ani değişimleri oluşturur.
- Eğri analizi, tüm veriler üzerinde yüksek, düşük, dönüm ve eyer noktalarını arar. Temel, yerel polinom uyumları ile eğim ve eğrilik ani artışlarıdır.
- Erken gösterge ve zaman dilimi öncülünü karşılaştırın: Tokyo, Avrupa ve New York – gerçek öncül ile sadece örtüşme arasında net bir ayrım yaparak.
- Spektral analiz, periyot uzunluklarını, döngü kararlılığını, anlık döngüleri ve SSA’yı inceler.
- Sermaye akışı, yeniden dağıtımı giriş ve çıkışlardan ayırır ve olası rotasyon şüphesini tespit eder.
- Bot sürülerinin analizi, binlerce olay üzerinden, kamuya açık tetikleyicilerin piyasada gerçekte ne gibi izler bıraktığını ölçer.
Buradaki belirleyici soru asla sadece “Bir örüntü var mı?” değildir; asıl soru şudur: “Bu örüntü, yöntemin daha önce görmediği verilerle test edildiğinde, bundan bir şey kalır mı?”
35 haber kaynağı – her dilde
Sistem, fiyat hareketleriyle paralel olarak saat başı haberleri tarar. Şu anda on bir bölgeden 35 kaynak ve 11.644 haber bulunmaktadır.
Bunlar arasında Reuters, WSJ, FT, CNBC, MarketWatch, Handelsblatt, NZZ, Der Standard, Nikkei, South China Morning Post, Economic Times, CoinDesk ve Cointelegraph. Bunlara ek olarak Fed, ECB, İngiltere Merkez Bankası, BIS ve SEC ile dünya olayları için BM Haberleri de yer almaktadır.
En önemli nokta, dilden bağımsız olmasıdır. Bu gömme modeli bge-m3 Çok dillidir: Almanca bir soruya, herhangi bir yerde çeviri yapılmasına gerek kalmadan Japonca bir haber de yanıt bulur. Çeviri adımı yoktur, çünkü buna gerek yoktur – vektörler aynı uzayda yer alır.
Sosyal medya kanalları şu anda henüz dahil edilmemiştir. Besleme katmanı, ilke olarak her türlü RSS veya Atom kaynağını alabilir. Dolayısıyla teknik genişletme küçüktür; asıl iş, sinyal kalitesini ölçmektir.
Eğer bugünün haberi dünün araştırmasıyla kesişirse
Aynı vektör uzayında uzmanlık literatürü de yer alıyor: 55 kaynak, 42.219 bölümden oluşuyor; her birinde kaynak, sayfa ve metin bağlantısı bulunuyor.
İçindekiler:
- Limit emir defterleri, istatistiksel arbitraj, piyasa etkisi, işlem stratejileri ve ticarette derin öğrenme ile ilgili 41 arxiv çalışması,
- 12 kamu malı klasik eser, aralarında Lefèvre, Selden, Harper, Clews, Crump, Gibson, Lawson, Rice, Brandenburg, Butler ve Francis,
- piyasa mikro yapısı ve algoritmik ticaret üzerine bir doktora tezi,
- yüksek frekanslı ticaret üzerine bir BIZ çalışma kağıdı.
Haberler ve literatür birbirinden ayrı silolarda bulunmaz. Bir kayıp kaçınma sorusu, ders kitabında uygun yeri bulur ve aynı zamanda bu sabahki haberi de – hiç kimse bu bağlantıyı manuel olarak kurmamış olsa bile.
NVIDIA Nemotron: Kahin yerine açıklayıcı
nemotron3:33b tahminler, grafik olayları, bağlantılar ve toplanan bilgiye ilişkin soruları yanıtlar. Burada geçerli olan katı bir kural vardır: Model hiçbir sayıyı uydurmamalıdır.
Her sayı bir araç çağrısından gelir. Bu çağrının adı, argümanları ve sonucu her cevabın altında yer alır. Bir ifadeye güvenmeyenler kontrol edebilir.
Nemotron, sorunun dilinde yanıt verir. Bu süreçte model açıkça bir açıklama aracıdır, bir kehanet değildir: Model, mevcut tahminleri okur, bunları sınıflandırır ve ilişkileri açıklar. Tahminleri kendisi üretmez. Bu nedenle, Akıl Yürütme sütunu sonuç üzerinde hiçbir ağırlığa sahip değildir.
Her gün ortaya çıkanlar
Sistem şu ana kadar 24 saatten bir yıla kadar uzanan yedi farklı zaman diliminde 978.837 canlı tahmin üretmiştir. Bunlardan 303.465'i, daha sonra gerçekleşen fiyatlarla karşılaştırılarak değerlendirilmiştir.
Bundan her gün ortaya çıkan şey:
- hareket gösterenleri, bunlarla ilgili haberleri ve ölçümlerin sonuçlarını bir araya getiren bir piyasa günlüğü, ve
- dikkat çeken noktaların günlük özeti, dikkat çekme derecesine ve ilgili sütunun ölçülen getirisine göre ağırlıklandırılmış olarak,
- trendler, dikkat çeken noktalar ve öngörüler ile bunların görünür kalitesi.
Günlük, kasıtlı olarak dil modeli kullanılmadan yazılır. Her rakam bir sorgudan elde edilir; bunu çevreleyen cümle bir şablondur ve serbestçe oluşturulmuş bir metin değildir.
Bunun nedeni çok somuttur: Daha küçük bir model bir keresinde 1,0034'lük bir hata oranını “neredeyse mükemmel” olarak yorumlamış ve böylece araç çıktısının tam tersini iddia etmişti. Bir günlüğe veya bloga giren her şeyin yeniden hesaplanabilir olması gerekir.
En önemli kısım: Bunlardan hangisi gerçekten işe yarıyor?
Her tahmin, fiilen gerçekleşen fiyatla karşılaştırılarak değerlendirilir. Geriye dönük bir hesaplamada değil, bu uygulamanın hiçbir modelinin daha önce görmediği fiyatlarla karşılaştırılır.
Isabet oranı, hata oranı ve maliyet bazında beklenen değer, her bir değer ve zaman aralığı için doğrudan arayüzde – ilgili tahminin yanında gösterilir.
CRSOFT.StockCrawler'ın hiçbir şekilde alım tavsiyesinde bulunmamasının nedeni de budur. Bir tahminin ölçülen kalitesini doğrudan yanında gören birinin hazır bir tavsiyeye ihtiyacı yoktur. Kendi kararını, tekrar hesaplanabilir bir temele dayalı olarak verebilir.
Sekiz sütun, ancak kanıt olmadan ağırlık yok
Sekiz sütunun her biri, aynı verilere farklı bir soru yöneltir. Her biri etkinleştirilebilir ve ağırlıklandırılabilir. Ancak hiçbiri, ölçülmüş bir dayanak olmadan bir şeyi hareket ettiremez. Ağırlıklandırma, ayar × kazanç ile yapılır. Kazanç,
Ağırlıklandırma, “Düzenleyici × Kazanç” formülüyle yapılır. Kazanç, kısıtlama aralığından gelir – ayardan değil.
| Sütun | Görev |
|---|---|
| Kurs öğrenme | Ağırlıkları sürekli olarak kendi hatalarından yenilenen beş alt model. Şu anda kaydedilmiş tahminlere dahil edilen tek sütun. |
| Matematiksel Analiz | Spektrum, döngü kararlılığı, anlık döngü, SSA ve Hurst – tek tek seriler üzerinde sinyal işleme. |
| Sermaye Akışı | Giriş ve çıkışlara karşı yeniden dağıtım, rotasyon şüphesi ve toplamı sabit kalan gruplar. |
| Derin Öğrenme | Ayrı zaman dilimlerine ait üç ONNX modeli, işlem sırasında CPU üzerinde. |
| Bilgi | Gömülü uzmanlık literatürü ve ölçülen bot kalıpları, bir katkı olarak. |
| Anlam Bilimi | Haber tonu, daha sonra elde edilen getiriye göre kalibre edilmiştir. |
| Akıl Yürütme | Açıklama sağlar, ancak hesaplamaya dahil edilmez. |
| Eğri analizi | Yerel polinom uyumu yoluyla yüksek, düşük, dönüm ve eyer noktaları. Analizden |
Analizden sanal portföye
CRSOFT.StockCrawler, korelasyonlar ve tahminlerle yetinmez. Uygulama, sinyallerin daha gerçekçi koşullar altında nasıl davrandığını da inceler.
Analiz
- 397.011 değerlendirilmiş çift üzerinden korelasyonlar ve erken göstergeler, en iyi gecikme süresi ve yön dahil
- Normalleştirilmiş eğrilerin kesişimleri, çifti kârına göre sıralama ve ayrı zaman dilimlerinden elde edilen performans
- Tüm portföy üzerinde eğri analizi, nedensel veya merkezlenmiş şekilde düzeltilmiş, eşzamanlı olaylarla ilişkilendirilmiş
- Dünya portföyü ve zaman dilimleri; öncül ve sadece örtüşme durumlarının net bir şekilde ayrılması
- Bot sürüsü: kamuya açık tetikleyicilerin ölçülebilir izleri, örneğin hareketli ortalama, RSI ve Bollinger
- Tersine çıkarım: Bir sinyal, tersine çevrildiğinde belki de işe yarar mı?
Tahmin ve Kalite
- Yedi ufuk; her değer ve hedef tarih için tam olarak bir adet yinelenmeyen gözlem
- Öğrenme eğrisi: Sistem gerçekten daha iyi hale geliyor mu?
- Karışık karşılaştırma: Sütunları birleştirmek gerçekten de bir fayda sağlıyor mu?
- Geriye dönük bakış: Durgunluğa karşı birikmiş bir avantaj olarak
Ticaret ve Portföy
- Gün İçi İşlem: “Ne almalıyım?” değil, şunu sormalı: Ücretler düşüldükten sonra, bugün piyasa gün içinde bir işlem yapmaya değer mi?
- Değişim: Kendi portföyünüze göre portföy yeniden yapılandırma önerileri
- Uzun Vadeli: Getiriler, en derin düşüşler ve sepetler – görünür hayatta kalma çarpıklığıyla
- Sanal Portföy: EUR ve USD cinsinden hesaplar, işlem başına ücretler, muhasebe defteri ve varlık seyri
- Dört stratejili otomatik yatırım:
streng,aktiv,haltenveinvers. Ters strateji, karşı kontrol olarak en düşük değerlemeye sahip varlıkları tutar. Öncelikleaktiv − inverssinyalin bilgi içeriğini gösterir. Yenilikler: - Yeni girişler: Nasdaq halka arz takviminden ve Binance listeleme kataloğundan ön duyurular – başarısızlıklar da dahil olmak üzere tam bir kohort
Yerel olarak çalıştırılır, açık genişletilebilir
Tüm süreç tek bir bilgisayarda yürütülür. Fiyatlar, tahminler ve değerlemeler saat başı güncellenir; evren, analiz, yeni eklemeler ve otomatik pilot ise günlük olarak güncellenir.
Arayüz, 2.272 metinle tamamen Almanca ve İngilizce olarak mevcuttur. Başka bir dil eklemek teknik olarak sadece ek bir XML dosyası gerektirir.
İki rol, yalnızca bir sayfa listesiyle değil, doğrudan HTTP yöntemiyle korunur. Böylece bu kural, bugün henüz var olmayan uç noktalar için de geçerlidir.
Sırada ne var
Proje açık, ancak henüz tamamlanmadı. Listede yer alanlar arasında, şunlar da bulunuyor:
- değerlendirme kuyruğundaki
Ingest.Core/Analysis, - değerlendirme kuyruğundaki tıkanıklığın giderilmesi,
- kurs verileri içermeyen değerlerin ayıklanması,
- erişim verilerinin sosyal kanallar yerine
appsettings.json, - sosyal kanallardan gelen verilerin ek kaynaklar olarak kullanılması,
- SEC EDGAR'a entegrasyon,
- sanal portföydeki açığa satışlar,
- Diğer diller için eşleştirilmiş sayı ve tarih formatları.
Özellikle matematik kısmı kasıtlı olarak bağımlılıklardan arındırılmış ve kolayca test edilebilir. Bu sayede test kapsamı, yeni katkıda bulunanlar için en uygun giriş noktalarından biridir. CRSOFT.StockCrawler'ın ne olmadığı
CRSOFT.StockCrawler'ın ne olmadığı: Hiçbir ticaret sistemi ve hiçbir yatırım danışmanlığı değildir. Uygulama,
Bir alım satım sistemi veya yatırım danışmanlığı değildir. Bu uygulama hiçbir noktada neyin satın alınması gerektiğini belirtmez. O, bundan önceki soruyu yanıtlar:
Neler ölçülebilir – ve bu, maliyetleri karşılar mı? Maliyetleri karşılar mı?
Ölçülmüş kalitesi olmadan tahmin yoktur. Uygulamanın gösterdiği her rakama ait bir ölçüm vardır. Bu ölçüm, birisinin o rakamı olduğu gibi kabul edeceği yerde bulunur: tam yanında.
Bir yöntemin sınırlı alanda neyi karşılayıp neyi karşılamadığı, sonuçtaki ağırlığını belirler. Kanıtı olmayan bir sütun hiçbir şeyi hareket ettirmez – düzenleyicisi yüzte olsa bile.
Belki de bu projenin en büyük farkı tam da budur: CRSOFT.StockCrawler kesinlik satmaya çalışmaz. O, belirsizliği görünür kılar, bilinmeyen verilere dayalı iddiaları doğrular ve matematik, bilgi ve yapay zekanın ölçülebilir bir katkı sağladığı yerleri – ve sağlamadığı yerleri – açıkça gösterir.
Tüm ölçüm serileri – her sütun, her zaman aralığı için ve hiçbir sonuç getirmeyen yöntemler de dahil olmak üzere – şu adreste bulunan teknik belgelerde yer almaktadır: CRS.StockCrawler/docs/ ve uygulamanın kendisindedir. CRSOFT.StockCrawler, açık kaynaklı, yerel olarak çalışan bir
CRSOFT.StockCrawler, açık ve yerel olarak işletilen bir analiz projesidir. Yatırım danışmanlığı veya alım ya da satım tavsiyesi niteliği taşımaz.
репозиторий с бесплатным и открытым исходным кодом https://github.com/chrisreiter/CRSOFT.StockCrawler.AI
CRSOFT.StockCrawler: Когда цифры, новости и экспертные знания совместно анализируют рынок
Что, если бы одна система математически анализировала акции, ETF, криптовалюты и индексы 17 бирж — и одновременно понимала биржевые новости со всего мира, а также соответствующую специализированную литературу?
Независимо от языка. На одном компьютере. Без облака. Открыто и бесплатно.
Именно этим и является CRSOFT.StockCrawler.
Система объединяет данные о котировках, математические анализы, новости и специализированную литературу в едином векторном пространстве. NVIDIA Nemotron объединяет эту информацию — и обязана подтверждать каждое используемое число .
В цифрах это означает:
641 значение · 3,9 миллиона ценовых баров · 397 011 проанализированных пар значений · 35 источников новостей · 42 219 фрагментов специализированной литературы · 978 837 прогнозов.
Именно за такую структуру поставщики требуют пятизначные суммы за годовую лицензию.
Но затем наступает этап, который многие из них не предоставляют: оценка того, что из этого действительно работает. Всё проверяется на наличие запрещённых зон. И если какой-либо метод не даёт результата, это открыто отображается в интерфейсе — а не в мелком шрифте.
Вся цепочка в одной системе
   Kurse          17 Börsen, live, stündlich, zurück bis 2001
      ↓
   Mathematik     Korrelationen · Kreuzungen · Vorlauf · Kurvendiskussion
      ↓           Spektralanalyse · Kapitalfluss · Zeitzonen
   Nachrichten    35 Quellen weltweit, in jeder Sprache
      ↓
   Vektorraum     sprachunabhängig – gemeinsam mit der Fachliteratur:
      ↓           arXiv, Dissertationen, Klassiker
   Reasoning      NVIDIA Nemotron, das jede Zahl belegen muss
      ↓
   Täglich        Journal · Auffälligkeiten · Trends · Prognosen
641 показателя с 17 биржевых площадок
Отправной точкой являются 405 акций, 109 криптовалют, 107 фондов и ETF, а также 20 индексов и валют.
Данные поступают, в частности, из Xetra, а также из Парижа, Лондона, Цюриха, Токио, Амстердама, Вены, Милана, Мадрида, Стокгольма, Гонконга и с бирж США. В общей сложности база данных включает 3 941 331 ценовых баров с дневной и часовой детализацией — частично с data back to the year 2001. Каждый час появляются новые данные.
То, что у разных бирж разные торговые календари, на первый взгляд кажется мелочью. На самом деле это одна из самых распространённых ловушек: тот, кто проводит расчёты на основе необработанной временной сетки, быстро начинает измерять календарь, а не рынок — и делает это достаточно убедительно, чтобы в это поверить.
Три анализа в рамках этого проекта провалились именно из-за этого, прежде чем проблема была устранена.
Математика вместо интуиции
На основе этих данных начинается математический анализ:
- 397 011 пар значений были проанализированы на предмет корреляции, наилучшего расположения и направления.
- Пересечения показывают, когда две нормализованные кривые поменялись местами — с рейтингом по прибыли пары и результативности в отдельных временных интервалах.
- Анализ кривых ищет по всему массиву данных точки максимумов, минимумов, разворотов и седловин. Основой служат локальные полиномиальные аппроксимации, а также скачки наклона и кривизны.
- Сравнение ранних индикаторов и опережения временных зон: Токио, Европа и Нью-Йорк — с четким разделением реального опережения и простого перекрытия.
- Спектральный анализ исследует длину периодов, стабильность циклов, мгновенные циклы и SSA.
- Анализ потоков капитала различает перераспределение, приток и отток и выявляет возможные признаки ротации.
- Анализ стад ботов измеряет на основе тысяч событий, какие последствия общеизвестные триггеры на самом деле оставляют на рынке.
При этом решающий вопрос никогда не сводится только к тому: «Существует ли закономерность?» а заключается в следующем: «Останется ли от неё что-то, если проверить её на данных, с которыми данный метод ранее не сталкивался?»
35 источников новостей — на всех языках
Параллельно с котировками система ежечасно сканирует новости. В настоящее время это 35 источников из одиннадцати регионов и 11 644 статьи.
Среди них — Reuters, WSJ, FT, CNBC, MarketWatch, Handelsblatt, NZZ, Der Standard, Nikkei, South China Morning Post, Economic Times, CoinDesk и Cointelegraph. К ним добавляются ФРС, ЕЦБ, Банк Англии, БМР и SEC, а также UN News для освещения мировых событий.
Ключевым моментом является языковая независимость. Эта модель встраивания bge-m3 является многоязычной: немецкий запрос также найдет японское сообщение, при этом нигде не производится перевод. Этапа перевода нет, потому что в нём нет необходимости — векторы находятся в одном и том же пространстве.
Социальные сети пока не включены. Уровень фидов в принципе может принимать любой источник RSS или Atom. Техническое расширение, таким образом, незначительно; основная работа заключается в измерении качества сигнала.
Когда сегодняшнее сообщение сталкивается с вчерашними исследованиями
В том же векторном пространстве находится и специализированная литература: 55 источников с 42 219 абзацами, каждый из которых имеет источник, страницу и текстовую ссылку.
Включены:
- 41 работа из arxiv, посвящённая лимитным книгам заказов, статистическому арбитражу, рыночному воздействию, стратегиям исполнения и глубокому обучению в торговле,
- 12 классических работ, находящихся в общественном достоянии, в том числе Лефевра, Селдена, Харпера, Клюса, Крампа, Гибсона, Лоусона, Райса, Бранденбурга, Батлера и Фрэнсиса,
- диссертация по микроструктуре рынка и алгоритмической торговле,
- рабочий документ БМР по высокочастотной торговле.
Новости и литература не хранятся в отдельных «силосах». Вопрос, касающийся аверсии к убыткам, находит соответствующее место в учебнике и, в то же время, в утреннем выпуске новостей — при этом никто не создавал эту связь вручную.
NVIDIA Nemotron: объясняющий инструмент, а не оракул, вместо оракула
nemotron3:33b отвечает на вопросы о прогнозах, событиях на графиках, взаимосвязях и накопленных знаниях. При этом действует жесткое правило: модель не должна придумывать никаких чисел.
Каждое число происходит из вызова инструмента. Имя, аргументы и результат этого вызова указаны под каждым ответом. Кто не доверяет какому-либо утверждению, может проверить.
Nemotron отвечает на том же языке, что и вопрос. При этом он является исключительно объяснителем, а не оракулом: модель считывает имеющиеся прогнозы, классифицирует их и объясняет взаимосвязи. Она сама не генерирует прогнозы. Поэтому столбец «Рассуждения» также не имеет влияния на результат.
Что создаётся каждый день
Система к настоящему моменту сгенерировала 978 837 прогнозов в режиме реального времени на семь временных горизонтов — от 24 часов до одного года. 303 465 из них уже были проанализированы с учетом курса, который позже фактически сложился.
Ежедневно на их основе создаётся:
- рыночный журнал, в котором объединяется информация о том, что изменилось, что об этом сообщалось и какие результаты дают соответствующие измерения,
- ежедневный обзор заметных моментов, взвешенный по степени заметности, умноженной на измеренную прибыль соответствующего столбца,
- тенденции, отклонения и прогнозы с их очевидной степенью достоверности.
Журнал сознательно пишется без использования языковой модели. Каждое число получено в результате запроса; предложение вокруг него является шаблоном, а не свободно сгенерированным текстом.
Причина этого весьма конкретна: однажды небольшая модель интерпретировала коэффициент ошибок 1,0034 как «практически идеальный» и, таким образом, утверждала, что результат противоположен выводу инструмента. То, что попадает в журнал или блог, должно оставаться поддающимся пересчёту.
Самая важная часть: что из этого действительно имеет значение?
Каждый прогноз оценивается по отношению к курсу, который фактически реализовался. Не в рамках обратного расчёта, а по отношению к курсам, которые ни одна модель данного приложения никогда не видела.
Коэффициент точности, коэффициент ошибки и ожидаемое значение с учетом затрат отображаются для каждой стоимости и каждого горизонта непосредственно в интерфейсе — рядом с прогнозом, к которому они относятся.
Именно по этой причине CRSOFT.StockCrawler не дает рекомендаций по покупке. Тот, кто видит оцененное качество прогноза прямо рядом с ним, не нуждается в готовой рекомендации. Он может принять собственное решение — на основе данных, которые можно проверить после факта.
Восемь столбцов, но никакой весовой оценки без подтверждения
Каждый из восьми столбцов задает тот же набор данных по-своему. Каждый из них можно включить и присвоить ему вес. Но ни один из них не влияет на результат без измеренной поддержки.
Взвешивание осуществляется с помощью регулятора × заслуги. Заслуга происходит из запретной зоны — а не из настройки.
| Столбец | Задача |
|---|---|
| Обучение курсу | Пять подмоделей, веса которых постоянно корректируются на основе собственной ошибки. Единственный столб, который в настоящее время учитывается в сохраненных прогнозах. |
| Математический анализ | спектр, стабильность циклов, мгновенный цикл, SSA и коэффициент Херста – обработка сигналов по отдельным рядам. |
| Движение капитала | Перераспределение по притокам и оттокам, подозрение на ротацию и группы, в которых сумма сохраняется. |
| Глубокое обучение | Три модели ONNX с отдельными временными диапазонами, обрабатываемые на ЦП. |
| Знания | Встроенная специализированная литература и зафиксированные шаблоны поведения ботов в качестве вклада. |
| Семантика | Настроение новостей, откалиброванное по полученной впоследствии доходности. |
| Рассуждения | Дает объяснение, но не участвует в расчетах. |
| Обсуждение кривых | Точки максимума, минимума, разворота и седла посредством локальной полиномиальной аппроксимации. |
От анализа до виртуального портфеля
CRSOFT.StockCrawler не ограничивается корреляциями и прогнозами. Приложение также анализирует, как сигналы ведут себя в более реалистичных условиях.
Анализ
- корреляции и опережающие индикаторы по 397 011 проанализированных пар, including оптимальное отставание и направление
- пересечения нормализованных кривых с рейтингом по прибыли пары и результатам за отдельные периоды
- Обсуждение кривых по всему набору данных: с причинно-следственной связью или центрированное сглаживание, с увязкой одновременных событий
- мировой портфель и часовые пояса с чётким разделением предшествующего периода и простого перекрытия
- Стадо ботов: измеримые следы общеизвестных триггеров, таких как скользящее среднее, RSI и Боллинджера
- Обратный вывод: может ли сигнал оказаться пригодным, если его перевернуть?
Прогноз и качество
- Семь горизонтов, для каждого значения и целевой даты ровно одно устраненное дублирование наблюдение
- Кривая обучения: действительно ли система становится лучше?
- Смешанное сравнение: приносит ли объединение столбцов вообще какую-то пользу?
- Обзор как суммарное преимущество по сравнению с застоем
Торговля и депозит
- Дневная торговля: не «Что мне купить?», а: Оправдывает ли рынок сегодня сделку в течение дня, после вычета комиссий?
- Обмен: предложения по перераспределению с учетом собственного портфеля
- Долгосрочные инвестиции: доходность, самые глубокие падения и корзины – с заметным искажением, связанным с выживанием
- Виртуальный портфель: расчетные счета в евро и долларах США, комиссии за каждую операцию, журнал учета и динамика активов
- Автопилот с четырьмя стратегиями:
streng,aktiv,haltenиinvers. Стратегия инверсного типа использует активы с самой низкой оценкой в качестве контрольной группы. Сначалаaktiv − inversпоказывает информационную ценность сигнала. - Новые поступления: предварительные объявления из календаря IPO Nasdaq и каталога листингов Binance — в виде полной когорты, включая неудачные
Работает локально, открыто для расширения
Весь процесс работает на одном компьютере. Котировки, прогнозы и оценки обновляются ежечасно; универсум, анализ, новые записи и автопилот — ежедневно.
Интерфейс с 2 272 текстами полностью доступен на немецком и английском языках. Добавление любого другого языка технически заключается в добавлении всего одного дополнительного XML-файла.
Две роли защищаются не просто с помощью списка страниц, а непосредственно на уровне HTTP-метода. Таким образом, это правило распространяется также на конечные точки, которые на сегодняшний день ещё даже не существуют.
Что запланировано на будущее
Проект открыт, но ещё не завершён. В списке, среди прочего, figurieren:
- расширение тестового покрытия для
Ingest.Core/Analysis, - устранение затора в очереди оценки,
- отсев значений без данных о курсах,
- хранение данных доступа в «User Secrets», а не в
appsettings.json, - социальные сети в качестве дополнительных источников,
- подключение к SEC EDGAR,
- короткие продажи в виртуальном депозитарии,
- согласованные форматы чисел и дат для других языков.
Именно математическая часть сознательно не зависит от других компонентов и хорошо поддается тестированию. Поэтому тестовое покрытие является одной из наиболее благодарных отправных точек для новых участников.
Чем CRSOFT.StockCrawler не является: Это
Это не торговая система и не инвестиционная консультация. Приложение нигде не указывает, что следует покупать. Оно отвечает на предшествующий вопрос:
Что вообще можно измерить — и окупает ли это затраты?
Не бывает прогноза без оценки его качества. Каждая цифра, которую отображает приложение, основана на измерении. Это измерение находится там, где кто-то в противном случае принял бы цифру за чистую монету: прямо рядом с ней.
То, что в критической зоне оправдывает затраты, а что нет, определяет его вес в конечном результате. Столб без подтверждения ничего не двигает — даже если его регулятор установлен на сто.
Возможно, именно в этом заключается главное отличие этого проекта: CRSOFT.StockCrawler не пытается продавать уверенность. Он делает неопределённость видимой, проверяет утверждения на неизвестных данных и открыто показывает, где математика, знания и ИИ вносят измеримый вклад — а где нет.
Полные ряды измерений — по каждому столбцу, по каждому горизонту и включая методы, которые не дали результата, — приведены в технической документации в разделе CRS.StockCrawler/docs/ и в самом приложении. CRSOFT.StockCrawler — это открытый проект по анализу, работающий локально.
CRSOFT.StockCrawler — это открытый, работающий локально проект по анализу. Он не является инвестиционным консультированием и не представляет собой рекомендацию по покупке или продаже.
مستودع مجاني ومفتوح المصدر https://github.com/chrisreiter/CRSOFT.StockCrawler.AI
CRSOFT.StockCrawler: عندما تتضافر الأرقام والأخبار والمعرفة المتخصصة لقراءة السوق
ماذا لو كان هناك نظام واحد يقوم بتحليل الأسهم وصناديق الاستثمار المتداولة (ETFs) والعملات المشفرة و المؤشرات من 17 سوقًا للأوراق المالية تحليلاً رياضيًا – وفي الوقت نفسه يفهم أخبار البورصات من جميع أنحاء العالم بالإضافة إلى الأدبيات المتخصصة في هذا المجال ؟
بغض النظر عن اللغة. على جهاز كمبيوتر واحد. بدون سحابة. مفتوح ومجاني.
هذا هو بالضبط CRSOFT.StockCrawler.
يجمع النظام بين بيانات الأسعار والتحليلات الرياضية والأخبار والمؤلفات المتخصصة في فضاء متجه مشترك. تقوم NVIDIA Nemotron بـ تجميع هذه المعلومات – ويجب عليها إثبات صحة كل رقم مستخدم؛ .
بالأرقام، هذا يعني:
641 قيمة · 3.9 مليون شريط أسعار · 397.011 زوج من القيم التي تم تحليلها · 35 مصدرًا إخباريًا · 42.219 مقطعًا من الأدبيات المتخصصة · 978.837 توقعات.
هذه هي البنية التي يطلب مقدمو الخدمة مقابلها تراخيص سنوية بخمسة أرقام .
ولكن بعد ذلك يأتي الجزء الذي لا يقدمه الكثيرون: قياس ما هو فعال فعليًّا من بين ذلك. يتم فحص كل شيء مقارنةً بنطاق حظر. وإذا كانت إحدى العمليات غير مجدية، فسيظهر ذلك بوضوح في الواجهة — وليس في التفاصيل المكتوبة بخط صغير.
السلسلة بأكملها في نظام واحد
   Kurse          17 Börsen, live, stündlich, zurück bis 2001
      ↓
   Mathematik     Korrelationen · Kreuzungen · Vorlauf · Kurvendiskussion
      ↓           Spektralanalyse · Kapitalfluss · Zeitzonen
   Nachrichten    35 Quellen weltweit, in jeder Sprache
      ↓
   Vektorraum     sprachunabhängig – gemeinsam mit der Fachliteratur:
      ↓           arXiv, Dissertationen, Klassiker
   Reasoning      NVIDIA Nemotron, das jede Zahl belegen muss
      ↓
   Täglich        Journal · Auffälligkeiten · Trends · Prognosen
641 قيمة من 17 سوقًا للأوراق المالية
نقطة البداية هي 405 أسهم، و109 عملات مشفرة، و107 صناديق استثمار وصناديق الاستثمار المتداولة (ETFs)، بالإضافة إلى 20 مؤشرًا وعملات أجنبية.
تأتي البيانات من Xetra، من بين مصادر أخرى، وكذلك من باريس ولندن و زيورخ وطوكيو وأمستردام وفيينا وميلانو ومدريد وستوكهولم وهونغ كونغ و من البورصات الأمريكية. ويشمل المخزون الإجمالي 3,941,331 شريط أسعار بدقة يومية وساعية – يعود بعضها إلى عام 2001. وتُضاف بيانات جديدة كل ساعة.
إن اختلاف تقويمات التداول بين البورصات المختلفة، يبدو في البداية وكأنه مجرد تفصيل بسيط. لكنه في الواقع أحد أكثر الفخاخ شيوعًا: فمن يحسب استنادًا إلى الإطار الزمني الخام، سرعان ما يقيس التقويم بدلاً من السوق – وبشكل مقنع بما يكفي لتصديق ذلك.
وقد فشلت ثلاث تحليلات لهذا المشروع بسبب هذا الأمر بالذات، قبل أن يتم حل المشكلة.
الرياضيات بدلاً من الحدس
يبدأ التحليل الرياضي على أساس هذه البيانات:
- تم تحليل 397.011 زوجًا من القيم من حيث الارتباط، و«أفضل» توقيت واتجاه.
- تُظهر نقاط التقاطع متى تبادلت منحنيتان مُعَدَّلتان مراكزهما – مع ترتيب حسب ربح الزوج وأدائه في فترات زمنية منفصلة.
- يبحث تحليل المنحنيات في المجموعة الكاملة عن نقاط القمة والقيعان ونقاط الانعطاف ونقاط السرج. ويستند ذلك إلى التوافقات المحلية مع كثيرات الحدود، بالإضافة إلى اندفاعات الميل والانحناء.
- مقارنة المؤشرات المبكرة والتقدم الزمني بين المناطق časové zóny — طوكيو وأوروبا ونيويورك — مع فصل واضح بين التقدم الحقيقي والتداخل البسيط.
- يحلل التحليل الطيفي أطوال الفترات، استقرار الدورات، والدورات اللحظية، وSSA.
- يميز تدفق رأس المال بين إعادة التوزيع والتدفقات الداخلة والخارجة، ويكشف عن أي شكوك محتملة بشأن الدوران.
- يقيس تحليل قطعان الروبوتات، عبر آلاف الأحداث، ما تتركه المحفزات المعروفة علنًا فعليًّا في السوق .
والسؤال الحاسم في هذا الصدد لا يقتصر أبدًا على: هل هناك نمط؟ بل: هل يتبقى شيء منه عند اختباره على بيانات لم يسبق أن رآها هذا الإجراء من قبل؟
35 مصدرًا إخباريًا – بجميع اللغات
بالتوازي مع أسعار الأسهم، يقوم النظام بقراءة الأخبار كل ساعة. يبلغ العدد الحالي 35 مصدرًا من 11 منطقة و 11,644 مقالًا.
ومن بينها رويترز، ووول ستريت جورنال، وفاينانشال تايمز، وCNBC، وماركت ووتش، وهاندلسبلات، وNZZ، «دير ستاندارد»، و«نيكي»، و«ساوث تشاينا مورنينغ بوست»، و«إيكونوميك تايمز»، و«كوينديسك» و«كوينتيليغراف». بالإضافة إلى ذلك، هناك «البنك الاحتياطي الفيدرالي»، و«البنك المركزي الأوروبي»، و«بنك إنجلترا»، و«بنك التسويات الدولية»، و«لجنة الأوراق المالية والبورصات» وكذلك «أخبار الأمم المتحدة» لتغطية الأحداث العالمية.
النقطة الحاسمة هي الاستقلالية اللغوية. إن نموذج التضمين هذا متعدد اللغات: فكل سؤال باللغة الألمانية bge-m3 متعدد اللغات: فالسؤال الألماني يجد خبرًا يابانيًا دون الحاجة إلى ترجمة في أي مكان . لا توجد خطوة ترجمة، لأنها غير ضرورية – فـ المتجهات تقع في نفس الفضاء.
لا تشمل القنوات الاجتماعية في الوقت الحالي. يمكن لطبقة التغذية بشكل أساسي استيعاب أي مصدر RSS أو Atom. وبالتالي، فإن التوسعة التقنية صغيرة؛ أما العمل الفعلي فيتمثل في قياس جودة الإشارة.
عندما تلتقي أخبار اليوم بأبحاث الأمس
تقع المراجع المتخصصة أيضًا في نفس الفضاء المتجهي: 55 مصدرًا تحتوي على 42,219 مقطعًا، كل منها مع المصدر والصفحة ورابط النص.
وتشمل:
- 41 بحثًا من arxiv حول دفاتر أوامر الحد، المراجحة الإحصائية، تأثير السوق، استراتيجيات التنفيذ، والتعلم العميق في التداول،
- 12 كتابًا كلاسيكيًا في المجال العام، من بينها أعمال ليففر، سيلدن، هاربر، كليوز، كрамب، جيبسون، لوسون، رايس، براندنبورغ، بتلر وفرانسيس،
- أطروحة دكتوراه حول البنية الدقيقة للسوق والتداول الخوارزمي،
- ورقة عمل صادرة عن بنك التسويات الدولي (BIZ) حول التداول عالي التردد.
الأخبار والمؤلفات ليست معزولة عن بعضها. فـ\"السؤال\" المتعلق بـ\"تجنب الخسارة\" يجد مكانه المناسب في الكتاب الدراسي و\"في نفس الوقت\" في خبر هذا الصباح — دون أن يقوم أحد بإنشاء هذا\"الارتباط يدويًّا. \"NVIDIA Nemotron: شرح\" بدلاً من \"أوراكل\"
NVIDIA Nemotron: «المفسر» بدلاً من «العيون»
nemotron3:33b يجيب على الأسئلة المتعلقة بالتنبؤات، وأحداث المنحنيات، والروابط، والمعرفة المجمعة. وفي هذا الصدد، تُطبق قاعدة صارمة: لا يجوز للنموذج أن يختلق أي رقم .
كل رقم ينبع من استدعاء أداة. ويظهر الاسم، والمعلمات، و نتيجة هذا الاستدعاء أسفل كل إجابة. ومن يشك في صحة أي عبارة، يمكنه التحقق منها.
يُجيب Nemotron بلغة السؤال. وهو في ذلك بشكل صريح «مفسر»، وليس «عرافًا»: فالنموذج يقرأ التوقعات الموجودة، ويصنفها، ويشرح الروابط بينها. وهو لا يولد التوقعات بنفسه. ولهذا السبب، فإن ركيزة «الاستدلال» (Reasoning) أيضًا لا تؤثر على النتيجة.
ما يتم إنتاجه كل يوم
أنتج النظام حتى الآن 978,837 توقعات حية على سبعة آفاق زمنية – من 24 ساعة إلى سنة واحدة. تم بالفعل تقييم 303,465 منها مقارنةً بالسعر الذي تحقق فعليًا لاحقًا.
وينتج عن ذلك يوميًا:
- مجلة سوق تجمع ما حدث، ما تم الإبلاغ عنه، وما توصلت إليه القياسات في هذا الصدد،
- نظرة عامة يومية على النقاط البارزة، مُرجحة حسب درجة البروز مضروبة في العائد المقاس لكل عمود من الأعمدة،
- الاتجاهات، والظواهر البارزة، والتوقعات مع تدليلها على أساس جودتها الظاهرة. يتم كتابة اليومية عمدًا بدون نموذج لغوي. كل رقم مستمد من استعلام؛ والجملة المحيطة به هي نموذج وليس نصًا مُنتجًا بحرية.
يتم كتابة اليومية عمدًا بدون نموذج لغوي . كل رقم مستمد من استعلام؛ والجملة المحيطة به هي نموذج وليس نصًا مُنتجًا بحرية.
والسبب في ذلك محدد جدًّا: فقد فسّر نموذج أصغر حجمًا في إحدى المرات نسبة خطأ قدرها 1,0034 على أنها «شبه مثالية» و ادّعى بذلك عكس ما أظهرته الأداة. ما يُنشر في دفتر يوميات أو مدونة يجب أن يظل قابلاً للتحقق.
الجزء الأهم: ما الذي يُفيد حقًّا؟
يتم تقييم كل توقّع مقارنةً بالسعر الذي تحقّق فعليًّا. ليس في حساب رجعي، بل مقارنةً بأسعار لم يسبق لأي نموذج في هذا التطبيق أن رآها من قبل.
تظهر نسبة الدقة، ونسبة الخطأ، والقيمة المتوقعة بعد احتساب التكاليف لكل قيمة ولكل أفق زمني مباشرةً في الواجهة – بجانب التوقعات التي تشير إليها.
وهذا هو السبب أيضًا في أن CRSOFT.StockCrawler لا تقدم أي توصيات شراء. فمن يرى جودة التوقعات المقاسة مباشرةً بجانبها، لا يحتاج إلى توصية جاهزة. يمكنه اتخاذ قراره الخاص—على أساس يمكن التحقق منه.
ثمانية أركان، ولكن لا وزن بدون دليل
كل ركيزة من الركائز الثماني تطرح سؤالًا مختلفًا على نفس البيانات. يمكن تفعيل كل منها وتقييمها. لكن لا شيء منها يؤثر دون دعم مقاس.
يتم الترجيح باستخدام «المتحكم × الاستحقاق». ويأتي الاستحقاق من منطقة الحظر – وليس من الإعداد.
| الركيزة | المهمة |
|---|---|
| تعلم المسار | خمسة نماذج جزئية، يتم تعديل أوزانها باستمرار بناءً على أخطائها الخاصة. الركيزة الوحيدة التي تُدرج حاليًا في التوقعات المخزنة. |
| التحليل الرياضي | الطيف، واستقرار الدورات، ودورة اللحظة، وSSA، ومؤشر هيرست – معالجة الإشارات على السلسلة الفردية. |
| تدفق رأس المال | إعادة التوزيع مقابل التدفقات الداخلة والخارجة، والشك في الدوران، والمجموعات ذات المجموع الثابت. |
| التعلم العميق | ثلاثة نماذج ONNX عبر نطاقات أفقية منفصلة، قيد المعالجة على وحدة المعالجة المركزية (CPU). |
| المعرفة | المؤلفات المتخصصة المدمجة وأنماط الروبوتات المقاسة كـ مساهمة. |
| الدلالة | مزاج الأخبار، مُعاير مقابل العائد الذي تحقق بعد ذلك . |
| الاستدلال | يشرح، لكنه لا يدخل في الحسابات. |
| مناقشة المنحنيات | نقاط القمة والقاع والانعطاف والركوب عبر التوافق المحلي مع دالة كثيرات الحدود. |
من التحليل إلى الحافظة الافتراضية
لا يقتصر CRSOFT.StockCrawler على الارتباطات والتوقعات فحسب. بل يدرس التطبيق أيضًا كيف تتصرف الإشارات في ظل ظروف أكثر واقعية.
التحليل
- الارتباطات والمؤشرات المبكرة عبر 397.011 زوجًا تم تحليلها، بما في ذلك أفضل توقيت واتجاه
- تقاطعات المنحنيات المعيارية مع ترتيب حسب ربح الزوج و الأداء خلال فترات زمنية منفصلة
- مناقشة المنحنيات عبر المحفظة بأكملها، سواء كانت سببية أو مركزة أو مُسوَّاة، مع ربط الأحداث المتزامنة
- المخزون العالمي والمناطق الزمنية مع فصل واضح بين الفترة التمهيدية و التداخل البسيط
- قطيع الروبوتات: آثار قابلة للقياس لمحفزات معروفة علنًا مثل المتوسط المتحرك، ومؤشر القوة النسبية (RSI)، وبولينجر
- الاستدلال العكسي: هل قد تكون الإشارة صالحة إذا ما قمنا بـ عكسها؟
التنبؤ والجودة
- سبعة آفاق، لكل قيمة ويوم مستهدف ملاحظة واحدة غير مكررة بالضبط ملاحظة
- منحنى التعلم: هل يتحسن النظام فعليًّا؟
- مقارنة مختلطة: هل يثمر دمج الأعمدة عن أي شيء على الإطلاق؟
- النظرة إلى الوراء باعتبارها تقدمًا تراكميًا مقارنة بالركود
التداول وحساب الأوراق المالية
- التداول اليومي: ليس «ماذا أشتري؟»، بل: هل يتيح السوق اليوم تداولًا خلال اليوم، بعد خصم الرسوم؟
- التبادل: اقتراحات إعادة التوزيع بناءً على المحفظة الخاصة
- الاستثمار طويل الأجل: العوائد، وأعمق الانخفاضات، والسلال – مع تشويه واضح لنتائج البقاء
- حافظة الأوراق المالية الافتراضية: حسابات التسوية باليورو و الدولار الأمريكي، والرسوم لكل معاملة، ودفتر الأستاذ، وتطور الأصول
- نظام التداول التلقائي بأربع استراتيجيات:
streng,aktiv,haltenوinvers. تُحتفظ الاستراتيجية العكسية بالأسهم الأقل تقييمًا كعنصر مراقبة مقابل. أولاًaktiv − inversيُظهر محتوى المعلومات في الإشارة. - الإضافات الجديدة: إعلانات مسبقة من تقويم الاكتتابات الأولية في ناسداك (Nasdaq) وكتالوج الإدراج في منصة بينانس (Binance) – كـ مجموعة كاملة تشمل حالات الفشل
يتم تشغيله محليًّا، وقابل للتوسيع بشكل مفتوح
تتم العملية بأكملها على جهاز كمبيوتر واحد. يتم تحديث الأسعار والتوقعات و التقييمات كل ساعة؛ أما نطاق التحليل و الإضافات الجديدة و«الطيار الآلي» فيتم تحديثها يوميًا.
الواجهة متاحة بالكامل باللغتين الألمانية والإنجليزية مع 2,272 نصًا. إضافة لغة أخرى لا تتطلب من الناحية التقنية سوى ملف XML إضافي.
يتم حماية دورين ليس فقط عبر قائمة من الصفحات، بل مباشرةً على طريقة HTTP. وبالتالي، تنطبق القاعدة أيضًا على نقاط النهاية التي لا توجد حتى الآن.
ما هو مخطط له بعد ذلك
المشروع مفتوح، لكنه لم يكتمل بعد. وتشمل قائمة المهام، من بين أمور أخرى، ما يلي:
- تغطية اختبارية أكبر لـ
Ingest.Core/Analysis, - حل الازدحام في رأس قائمة انتظار التقييم،
- استبعاد القيم التي لا تحتوي على بيانات الأسعار،
- تخزين بيانات الوصول في «أسرار المستخدم» بدلاً من
appsettings.json, - القنوات الاجتماعية كمصادر إضافية،
- الربط بنظام SEC EDGAR،
- عمليات البيع على المكشوف في الحافظة الافتراضية،
- تنسيقات الأرقام والتواريخ المقترنة للغات أخرى.
الرياضيات على وجه الخصوص خالية من التبعية بشكل متعمد ويمكن اختبارها بسهولة. وبالتالي، فإن تغطية الاختبار تعد واحدة من أكثر نقاط الانطلاق ملاءمةً لـ المساهمين الجدد.
ما لا يمثله CRSOFT.StockCrawler هو
ليس نظام تداول ولا استشارة استثمارية. لا تذكر التطبيق في أي موضع ما الذي يجب شراؤه. بل تجيب على السؤال الذي يسبق ذلك:
ما الذي يمكن قياسه أصلاً – وهل يغطي ذلك التكاليف؟
لا توجد توقعات دون قياس جودتها. كل رقم يعرضه التطبيق يستند إلى قياس. ويظهر هذا القياس في المكان الذي قد يأخذ فيه المرء الرقم على محمل الجد: مباشرة بجانبه.
ما يمكن لإجراء ما تحمله في المنطقة المحظورة وما لا يمكنه تحمله هو ما يحدد وزنه في النتيجة. العمود الذي يفتقر إلى الدليل لا يحرك شيئًا – حتى لو كان منظم قوته مضبوطًا على مائة.
ربما يكون هذا بالضبط هو الفارق الأكبر في هذا المشروع: لا يحاول CRSOFT.StockCrawler بيع اليقين. بل يجعل الشك واضحًا، ويفحص الادعاءات القائمة على بيانات مجهولة، ويُظهر بصراحة أين تساهم الرياضيات والمعرفة والذكاء الاصطناعي بشكل قابل للقياس – وأين لا تساهم.
تتوفر سلاسل القياس الكاملة — لكل عمود، ولكل أفق، و بما في ذلك الإجراءات التي لم تسفر عن أي نتائج — في الوثائق التقنية تحت عنوان CRS.StockCrawler/docs/ وفي التطبيق نفسه.
CRSOFT.StockCrawler هو مشروع تحليلي مفتوح يُدار محليًّا. ولا يمثل بأي حال من الأحوال استشارة استثمارية أو توصية بالشراء أو البيع.